Dentro il centro di Hangzhou che produce dati di addestramento per robot a milioni di ore
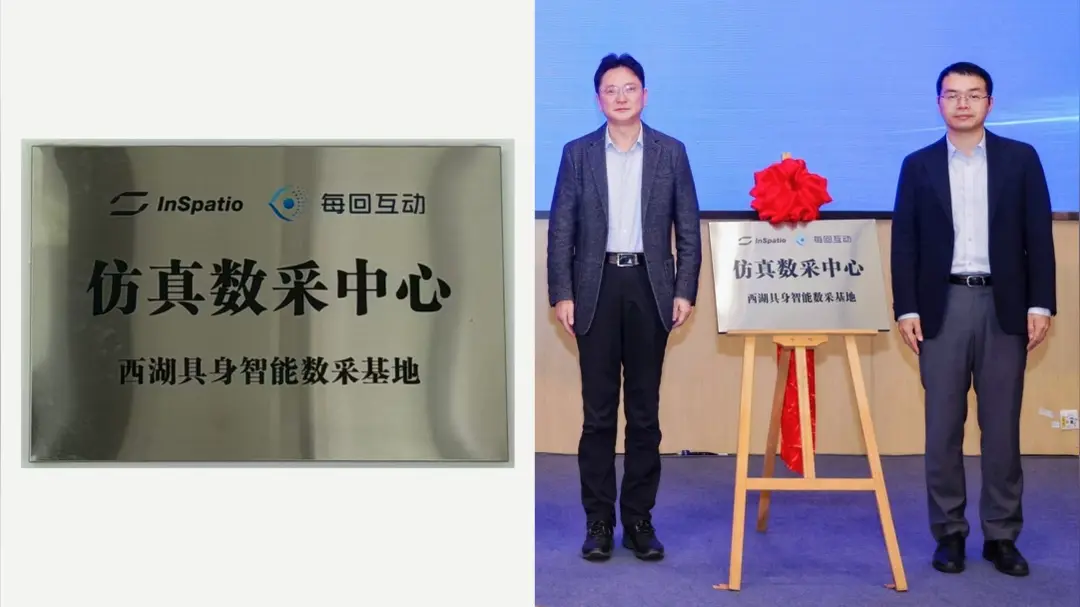
Addestrare un robot a piegare il bucato o a riempire gli scaffali richiede un’enorme quantità di video e dati di movimento, quel tipo di filmati di interazione multimodale che insegnano a un modello come si comportano gli oggetti quando una macchina li tocca. Il consenso del settore è che un modello di IA incarnata utilizzabile necessiti di decine di milioni di ore di questi dati. Ciò che esiste realmente, dopo due anni di sforzi in tutto il settore, è circa un milione di ore, e una volta eliminati i clip di bassa qualità, molto meno è davvero utilizzabile.
Questo divario è il business case alla base di una nuova struttura a Hangzhou, descritta come il primo centro cinese di raccolta dati di simulazione incarnata, gestito da una società chiamata Yingsu. La sua tesi è che il collo di bottiglia non è mai stato davvero il dato in sé. Era il metodo: la vecchia formula era persone moltiplicate per ore, con operatori umani che guidavano bracci robotici o indossavano sistemi di motion capture per generare ogni minuto utilizzabile.
La nuova formula, secondo l’azienda, è configurazioni ambientali moltiplicate per potenza di calcolo parallela. Invece di filmare un robot che svolge un compito in una stanza, il centro costruisce ambienti simulati e ne esegue molti contemporaneamente, generando scene, illuminazione, posizionamento degli oggetti e interazioni fisiche in parallelo. Un rapporto sul settore descrive un approccio correlato capace di produrre tre milioni di sandbox al giorno. L’unità di capacità si sposta dal turno dell’operatore al throughput del cluster di GPU.
Questo spostamento conta perché cambia chi può competere. La raccolta gestita da umani è economica all’inizio ma scala linearmente ed è difficile da mantenere coerente; la simulazione scala con l’hardware ma richiede fisica accurata, un’attenta randomizzazione del dominio e un modo per colmare il divario tra filmati sintetici e reali. Troppa simulazione e il robot impara una fisica pulita e collaborativa che nessuna cucina o magazzino fornisce. L’obiettivo dichiarato del centro è rompere quel collo di bottiglia centrale, non semplicemente aggiungere un altro mucchio di ore.
La tempistica riflette un umore più ampio nell’IA incarnata cinese, dove i produttori di robot umanoidi hanno attirato ingenti investimenti e un’intensa attenzione pubblica. L’hardware è avanzato più rapidamente del software che lo rende utile, e i dati sono diventati il vincolo riconosciuto. Una struttura che tratta la produzione di dati come un processo industriale — configurabile, parallelo, ripetibile — è una scommessa che i vincitori saranno coloro che sapranno fabbricare esperienza anziché limitarsi a registrarla.
La domanda aperta è la qualità. I filmati sintetici hanno valore solo se un modello addestrato in gran parte dentro un simulatore funziona ancora quando un robot fisico entra in una stanza sconosciuta. È lo stesso problema sim-to-real che i ricercatori di robotica inseguono da anni, e la sola scala non lo ha risolto. Il vero test del centro sarà se i dati che produce generano robot che si comportano in modo affidabile fuori dal laboratorio.
Per i lettori globali, questo riguarda meno una singola struttura e più una direzione di marcia: le aziende cinesi di IA incarnata stanno cercando di comprimere un decennio di raccolta dati in mesi trattandola come un problema di calcolo. Se l’approccio funziona, il costo di addestrare un cervello robotico capace cala bruscamente, e il prossimo vincolo diventa l’hardware, il deployment e la sicurezza anziché i filmati.