Im Inneren des Zentrums in Hangzhou, das Roboter-Trainingsdaten in Millionenhöhe produziert
Einen Roboter das Wäschezusammenlegen oder Regaleinräumen beizubringen, erfordert enorm viel Video- und Bewegungsdaten – jenes multimodale Interaktionsmaterial, das einem Modell beibringt, wie sich Objekte verhalten, wenn eine Maschine sie berührt. Der Branchenkonsens lautet, dass ein brauchbares Modell für verkörperte KI Dutzende Millionen Stunden davon benötigt. Tatsächlich existieren nach zwei Jahren Anstrengung in der gesamten Branche rund eine Million Stunden, und rechnet man die minderwertigen Clips heraus, ist weit weniger davon wirklich nutzbar.
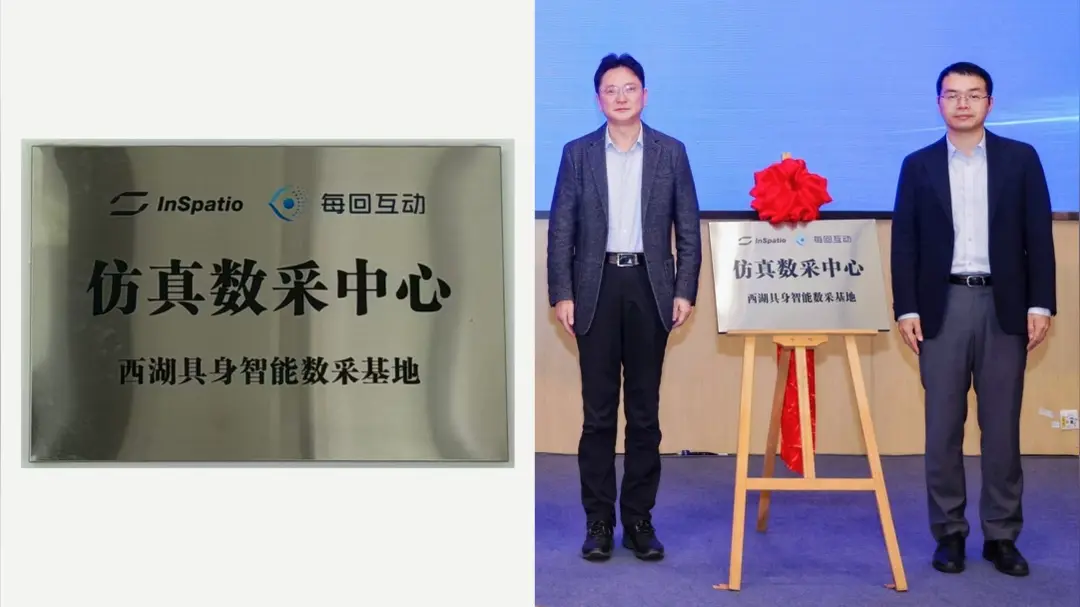
Diese Lücke ist das Geschäftsmodell hinter einer neuen Einrichtung in Hangzhou, die als landesweit erstes Zentrum zur Erfassung verkörperter Simulationsdaten beschrieben wird und von einem Unternehmen namens Yingsu betrieben wird. Dessen Argument: Der Engpass lag nie wirklich an den Daten als solchen, sondern an der Methode. Die alte Formel lautete Menschen mal Stunden, wobei menschliche Operatoren Roboterarme führten oder Motion-Capture-Anzüge trugen, um jede nutzbare Minute zu erzeugen.
Die neue Formel lautet nach Darstellung des Unternehmens Umgebungskonfigurationen mal parallele Rechenleistung. Statt einen Roboter bei einer Aufgabe in einem Raum zu filmen, baut das Zentrum simulierte Umgebungen und betreibt viele davon gleichzeitig, wodurch vielfältige Szenen, Beleuchtungen, Objektanordnungen und physikalische Interaktionen parallel entstehen. Ein Branchenbericht beschreibt einen verwandten Ansatz, der drei Millionen Testumgebungen pro Tag erzeugen kann. Die Kapazitätseinheit verschiebt sich von der Schicht des Operators zum Durchsatz des GPU-Clusters.
Dieser Wandel ist wichtig, weil er verändert, wer konkurrieren kann. Menschliche Datenerfassung ist billig im Einstieg, skaliert aber linear und ist schwer konsistent zu halten; Simulation skaliert mit der Hardware, verlangt aber präzise Physik, sorgfältige Domänenrandomisierung und einen Weg, die Lücke zwischen synthetischem und echtem Material zu schließen. Zu viel Simulation, und der Roboter lernt eine saubere, kooperative Physik, die keine Küche und kein Lager bietet. Das erklärte Ziel des Zentrums ist, diesen zentralen Engpass zu durchbrechen, statt einfach einen weiteren Haufen Stunden anzuhäufen.
Der Zeitpunkt spiegelt eine breitere Stimmung in der chinesischen verkörperten KI wider, in der Hersteller humanoider Roboter schwere Investitionen und intensive öffentliche Aufmerksamkeit auf sich gezogen haben. Die Hardware hat sich schneller entwickelt als die Software, die sie nutzbar macht, und Daten sind zur anerkannten Einschränkung geworden. Eine Einrichtung, die Datenproduktion als industriellen Prozess behandelt – konfigurierbar, parallel, wiederholbar –, ist eine Wette darauf, dass die Gewinner jene sein werden, die Erfahrung herstellen können, statt sie nur aufzuzeichnen.
Die offene Frage ist die Qualität. Synthetisches Material ist nur wertvoll, wenn ein überwiegend im Simulator trainiertes Modell noch funktioniert, wenn ein physischer Roboter in einen unbekannten Raum rollt. Das ist dasselbe Sim-to-Real-Problem, dem Robotikforscher seit Jahren nachjagen, und Skalierung allein hat es nicht gelöst. Der eigentliche Test des Zentrums wird sein, ob die Daten, die es ausstößt, Roboter hervorbringen, die sich außerhalb des Labors zuverlässig verhalten.
Für internationale Leser geht es weniger um eine einzelne Einrichtung als um eine Richtung: Chinesische Firmen für verkörperte KI versuchen, ein Jahrzehnt der Datenerfassung auf Monate zu komprimieren, indem sie sie als Rechenproblem behandeln. Wenn der Ansatz funktioniert, sinken die Kosten für das Training eines leistungsfähigen Robotergehirns stark, und die nächste Einschränkung werden Hardware, Einsatz und Sicherheit statt Filmmaterial.