Dentro del centro de Hangzhou que genera datos de entrenamiento robótico por millones de horas
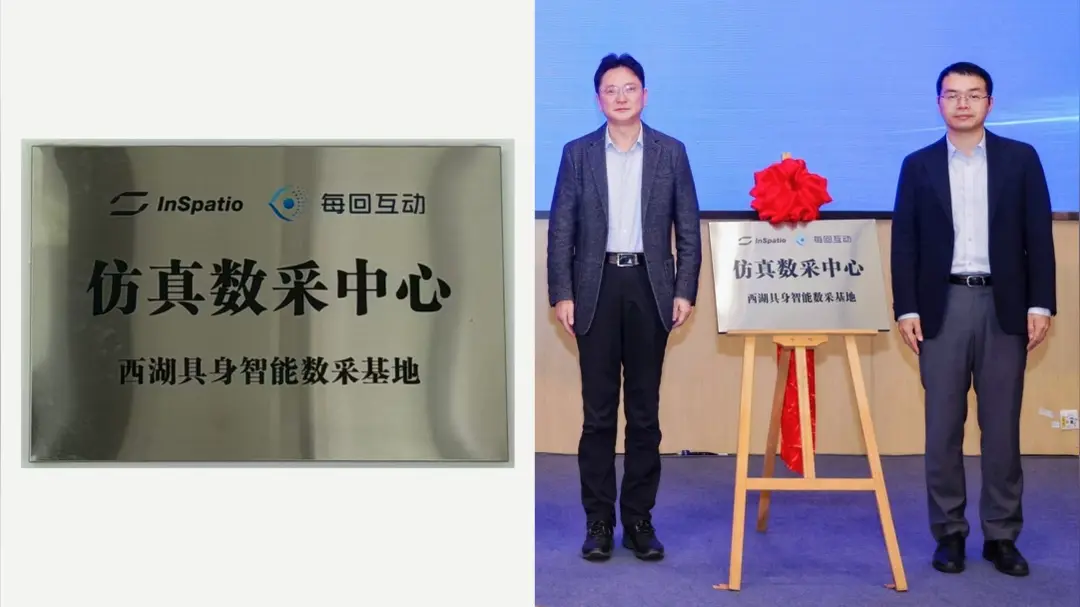
Entrenar a un robot para doblar la ropa o colocar productos en estanterías exige una cantidad enorme de vídeo y datos de movimiento: ese tipo de material de interacción multimodal que enseña a un modelo cómo se comportan los objetos cuando una máquina los toca. El consenso del sector es que un modelo de IA encarnada realmente útil necesita decenas de millones de horas de ese material. Lo que existe en realidad, tras dos años de esfuerzo en todo el sector, ronda el millón de horas, y si se descartan los clips de baja calidad, la cifra verdaderamente aprovechable es mucho menor.
Esa brecha es el argumento de negocio de una nueva instalación en Hangzhou, presentada como el primer centro de recopilación de datos de simulación encarnada del país y operada por una empresa llamada Yingsu. Su tesis es que el cuello de botella nunca estuvo realmente en los datos como tales, sino en el método: la fórmula antigua era personas multiplicadas por horas, con operadores humanos guiando brazos robóticos o equipados con trajes de captura de movimiento para generar cada minuto útil.
La nueva fórmula, tal como la plantea la empresa, es configuraciones de entorno multiplicadas por potencia de cómputo en paralelo. En lugar de filmar a un robot realizando una tarea en una habitación, el centro construye entornos simulados y ejecuta muchos a la vez, generando en paralelo escenas, iluminaciones, colocaciones de objetos e interacciones físicas variadas. Un informe sobre el sector describe un enfoque similar capaz de producir tres millones de entornos de prueba al día. La unidad de capacidad pasa del turno del operador al rendimiento del clúster de GPU.
Ese cambio importa porque altera quién puede competir. La recopilación con operadores humanos es barata al principio, pero escala de forma lineal y es difícil de mantener consistente; la simulación escala con el hardware, pero exige una física precisa, una cuidadosa aleatorización de dominios y una forma de cerrar la brecha entre el material sintético y el real. Con demasiada simulación, el robot aprende una física limpia y colaborativa que ninguna cocina ni almacén ofrece. El objetivo declarado del centro es romper ese cuello de botella central en lugar de limitarse a acumular otra pila de horas.
El momento refleja un ánimo más amplio en la IA encarnada china, donde los fabricantes de robots humanoides han atraído fuertes inversiones y una intensa atención pública. El hardware ha avanzado más rápido que el software que lo hace útil, y los datos se han convertido en la limitación reconocida. Una instalación que trata la producción de datos como un proceso industrial —configurable, paralelo, repetible— es una apuesta a que ganarán quienes puedan fabricar experiencia en lugar de limitarse a registrarla.
La pregunta abierta es la calidad. El material sintético solo vale si un modelo entrenado en gran medida dentro de un simulador sigue funcionando cuando un robot físico entra en una habitación desconocida. Es el mismo problema de simulación a realidad que los investigadores en robótica llevan años persiguiendo, y la escala por sí sola no lo ha resuelto. La verdadera prueba del centro será si los datos que produce dan lugar a robots que se comporten de forma fiable fuera del laboratorio.
Para el lector global, esto tiene menos que ver con una instalación concreta que con una dirección de avance: las empresas chinas de IA encarnada intentan comprimir una década de recopilación de datos en meses tratándola como un problema de cómputo. Si el enfoque funciona, el coste de entrenar un cerebro robótico capaz cae en picado, y la siguiente limitación pasa a ser el hardware, el despliegue y la seguridad, no el material audiovisual.