Внутри ханчжоуского центра, который производит данные для обучения роботов миллионами часов
Чтобы научить робота складывать бельё или расставлять товары на полках, требуется огромный объём видео и данных о движениях — тех самых мультимодальных записей взаимодействия, которые учат модель тому, как ведут себя предметы, когда их касается машина. По общему мнению отрасли, работоспособной модели воплощённого ИИ нужны десятки миллионов часов таких данных. В действительности же после двух лет усилий всей отрасли накоплено примерно миллион часов, а если отбросить клипы низкого качества, пригодных для использования окажется куда меньше.
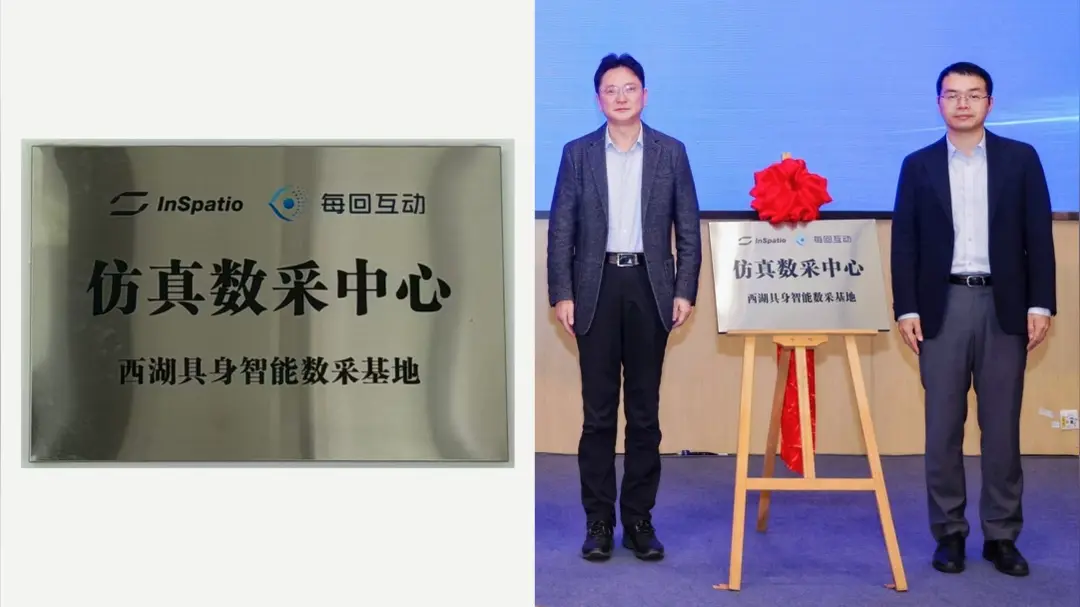
Именно этот разрыв лежит в основе бизнес-идеи нового объекта в Ханчжоу, который называют первым в стране центром сбора данных воплощённого моделирования; им управляет компания Yingsu. Её довод в том, что узким местом никогда не были сами данные. Дело было в методе: прежняя формула — это люди, умноженные на часы, когда операторы вручную управляют роботизированными манипуляторами или надевают костюмы захвата движения, чтобы получить каждую пригодную минуту.
Новая формула, как её формулирует компания, — это конфигурации среды, умноженные на мощность параллельных вычислений. Вместо съёмки одного робота, выполняющего одну задачу в одной комнате, центр строит смоделированные среды и запускает множество из них одновременно, параллельно порождая разнообразные сцены, освещение, расположение объектов и физические взаимодействия. Один отраслевой отчёт описывает родственный подход, способный создавать три миллиона песочниц в день. Единица мощности смещается от смены оператора к пропускной способности кластера GPU.
Этот сдвиг важен, потому что меняет расстановку сил в конкуренции. Сбор данных людьми дёшев на старте, но масштабируется линейно и трудно поддаётся поддержанию единообразия; симуляция масштабируется вместе с оборудованием, но требует точной физики, тщательной рандомизации домена и способа сократить разрыв между синтетическими и реальными кадрами. При избытке симуляции робот осваивает чистую, покладистую физику, которой не бывает ни на одной кухне или складе. Заявленная цель центра — преодолеть это ключевое узкое место, а не просто добавить ещё одну груду часов.
Выбор момента отражает более широкие настроения в китайском воплощённом ИИ, где производители человекоподобных роботов привлекли крупные инвестиции и пристальное внимание публики. Аппаратное обеспечение развивалось быстрее программного, которое делает его полезным, и данные стали признанным ограничением. Объект, который относится к производству данных как к промышленному процессу — настраиваемому, параллельному, воспроизводимому, — это ставка на то, что победят те, кто умеет производить опыт, а не просто записывать его.
Открытый вопрос — качество. Синтетические кадры ценны лишь в том случае, если модель, обученная преимущественно внутри симулятора, по-прежнему работает, когда физический робот въезжает в незнакомую комнату. Это та же проблема перехода из симуляции в реальность, за которой исследователи робототехники гоняются годами, и один лишь масштаб её не решил. Настоящая проверка центра — в том, дадут ли производимые им данные роботов, надёжно ведущих себя за пределами лаборатории.
Для читателей по всему миру речь идёт не столько об отдельном объекте, сколько о направлении движения: китайские компании в области воплощённого ИИ пытаются сжать десятилетие сбора данных в месяцы, рассматривая его как вычислительную задачу. Если подход сработает, стоимость обучения дееспособного роботизированного мозга резко упадёт, и следующим ограничением станут аппаратное обеспечение, развёртывание и безопасность, а не видеоматериал.