Binnen het centrum in Hangzhou dat miljoenen uren robot-trainingsdata produceert
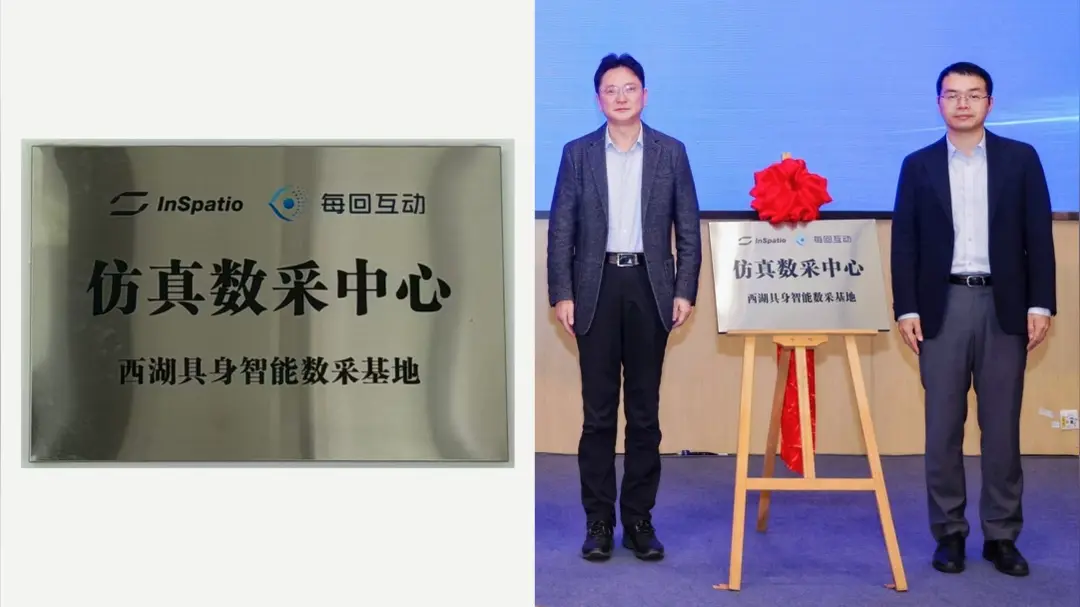
Een robot leren wasgoed op te vouwen of schappen te vullen vereist een enorme hoeveelheid video- en bewegingsdata — het soort multimodale interactiebeelden dat een model leert hoe objecten zich gedragen wanneer een machine ze aanraakt. De consensus in de sector is dat een bruikbaar embodied AI-model tientallen miljoenen uren nodig heeft. Wat na twee jaar inspanning in de hele sector daadwerkelijk bestaat, is ongeveer een miljoen uur, en zodra de clips van lage kwaliteit eruit worden gefilterd, is veel minder echt bruikbaar.
Die kloof is de businesscase achter een nieuwe faciliteit in Hangzhou, beschreven als het eerste centrum voor embodied simulatie-datacollectie van het land, gerund door een bedrijf genaamd Yingsu. Het argument is dat de bottleneck nooit echt om data als zodanig ging. Het ging om de methode: de oude formule was mensen maal uren, waarbij menselijke operators robotarmen bestuurden of motion-capture-uitrusting droegen om elke bruikbare minuut te genereren.
De nieuwe formule, zoals het bedrijf het formuleert, is omgevingsconfiguraties maal parallelle rekenkracht. In plaats van één robot te filmen die één taak in één kamer uitvoert, bouwt het centrum gesimuleerde omgevingen en draait er vele tegelijk, waarbij gevarieerde scènes, belichting, objectplaatsing en fysieke interacties parallel worden gegenereerd. Een rapport over de sector beschrijft een verwante aanpak die drie miljoen sandboxes per dag kan produceren. De eenheid van capaciteit verschuift van de dienst van de operator naar de doorvoer van de GPU-cluster.
Die verschuiving is belangrijk omdat ze verandert wie kan concurreren. Door mensen uitgevoerde verzameling is goedkoop om te beginnen maar schaalt lineair en is moeilijk consistent te houden; simulatie schaalt met hardware maar vereist nauwkeurige fysica, zorgvuldige domeinrandomisatie en een manier om de kloof tussen synthetische en echte beelden te dichten. Te veel simulatie en de robot leert een schone, meewerkende fysica die geen enkele keuken of magazijn biedt. Het doel van het centrum is die kernbottleneck te doorbreken in plaats van simpelweg nog een berg uren toe te voegen.
De timing weerspiegelt een bredere stemming in de Chinese embodied AI, waar fabrikanten van humanoïde robots zware investeringen en intense publieke aandacht hebben getrokken. Hardware is sneller gevorderd dan de software die het nuttig maakt, en data is de erkende beperking geworden. Een faciliteit die dataproductie als een industrieel proces behandelt — configureerbaar, parallel, herhaalbaar — is een gok dat de winnaars degenen zullen zijn die ervaring kunnen fabriceren in plaats van alleen vastleggen.
De open vraag is kwaliteit. Synthetische beelden zijn alleen waardevol als een model dat grotendeels in een simulator is getraind, nog steeds werkt wanneer een fysieke robot een onbekende kamer binnenrijdt. Dat is hetzelfde sim-to-real-probleem waar roboticaonderzoekers al jaren mee worstelen, en schaal alleen heeft het niet opgelost. De echte test van het centrum zal zijn of de data die het produceert robots oplevert die zich buiten het lab betrouwbaar gedragen.
Voor wereldwijde lezers gaat dit minder om één faciliteit dan om een reisrichting: Chinese embodied-AI-bedrijven proberen een decennium aan datacollectie tot maanden te comprimeren door het als een rekenprobleem te behandelen. Als de aanpak werkt, dalen de kosten van het trainen van een capabel robotbrein sterk, en wordt de volgende beperking hardware, implementatie en veiligheid in plaats van beeldmateriaal.