Il nuovo modello OCR di Baidu legge tutti e sette i libri di Harry Potter in una volta
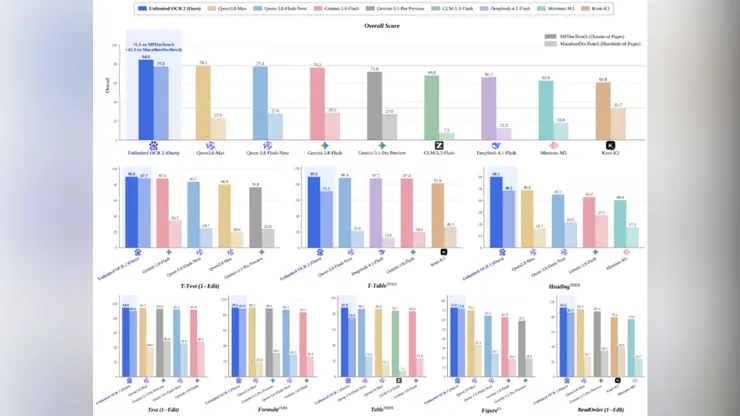
Il riconoscimento ottico dei caratteri, la tecnologia che trasforma le immagini di testo in parole modificabili, ha da sempre un limite. La maggior parte dei sistemi gestisce qualche decina di pagine prima che la precisione cali o l’uso di memoria esploda. Il 27 ottobre Baidu ha rilasciato e reso open source un modello chiamato Wenxin Unlimited OCR 2, che secondo l’azienda elimina del tutto questo limite.
L’azienda descrive il rilascio come la prima volta che un modello raggiunge l’analisi di documenti con un numero arbitrario di pagine, spostando il tetto di elaborazione da qualche decina di pagine verso quello che definisce illimitato. In una dimostrazione, il modello ha letto tutti e sette i romanzi di Harry Potter in un’unica esecuzione, per un totale di oltre 3.600 pagine, mantenendo elevata precisione e velocità di elaborazione man mano che la lunghezza del documento cresceva.
Il trucco tecnico è un meccanismo di attenzione che il team chiama SR-SWA. Invece di tenere ogni pagina in memoria contemporaneamente, il modello lavora come farebbe una persona che copia un libro lungo: guarda avanti, seleziona le pagine e i blocchi di informazione rilevanti per il passaggio corrente e mette da parte il resto. Un meccanismo di decodifica a blocchi assembla poi l’output. Baidu afferma che questo approccio ha ridotto l’uso massimo della cache KV in un test da cento pagine da 47 gigabyte a una piccola frazione, rendendo praticabili i documenti lunghi su hardware ordinario.
Secondo l’azienda, i benchmark pubblici per l’analisi di documenti multipagina, inclusi i test con prefisso M molto seguiti, mostrano che il modello raggiunge risultati all’avanguardia. Baidu presenta il rilascio come l’arrivo dell’era OCR 3.0, in cui l’analisi dei documenti non si giudica da quanto bene un modello legge una pagina, ma da quanto affidabilmente gestisce un intero archivio.
La posta in gioco pratica è alta. Contratti, atti giudiziari, cartelle cliniche, archivi storici e biblioteche accademiche arrivano tutti come pile di pagine scansionate. Un modello in grado di ingerirle in un solo passaggio potrebbe cambiare il modo in cui studi legali, ospedali ed editori digitalizzano i loro arretrati. Potrebbe anche alimentare direttamente i documenti lunghi negli assistenti AI, che hanno faticato con le finestre di contesto e il recupero delle informazioni quando è stato chiesto loro di ragionare su centinaia di pagine.
Rendere il modello open source abbassa la barriera per gli sviluppatori che vogliono costruire strumenti documentali senza pagare tariffe per pagina a un fornitore cloud. Baidu sta posizionando la sua famiglia Wenxin come base sia per i propri prodotti sia per gli sviluppatori esterni, e rilasciare gratuitamente il modello OCR rientra in questa strategia.
L’affermazione di pagine illimitate inviterà a un esame attento. Test indipendenti dovranno confermare che la precisione regge su scansioni disordinate del mondo reale, scrittura a mano e tabelle, non solo su pagine di libri pulite. Tuttavia, la demo è impressionante: un singolo modello che legge un’intera serie di sette libri in un colpo solo è il tipo di benchmark concreto che tende a restare impresso.
Per i lettori globali, il rilascio è un promemoria che i laboratori di AI cinesi competono duramente sull’ingegneria pratica oltre che sulle dimensioni dei modelli da prima pagina. L’analisi dei documenti è un lavoro poco glamour, ma sta alla base di una quota enorme dell’adozione dell’AI aziendale. Se il modello si comporta come pubblicizzato, il prossimo campo di battaglia sarà chi riuscirà per primo a trasformare la comprensione dei documenti lunghi in strumenti d’ufficio quotidiani.