Novo modelo OCR do Baidu lê os sete livros de Harry Potter de uma só vez
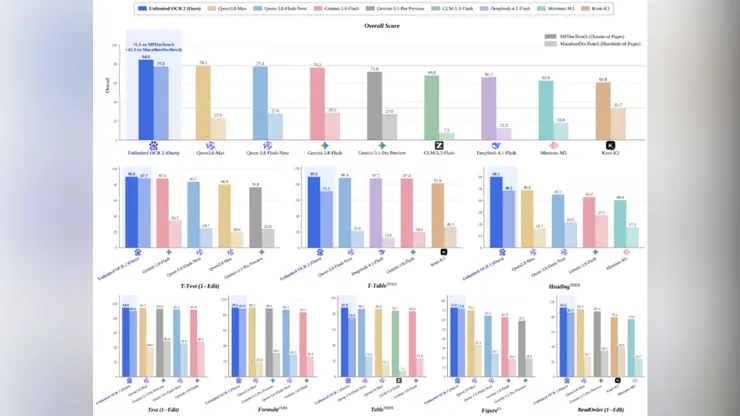
O reconhecimento óptico de caracteres, a tecnologia que transforma imagens de texto em palavras editáveis, há muito tempo tem um teto. A maioria dos sistemas dá conta de algumas dezenas de páginas antes que a precisão caia ou o uso de memória dispare. Em 27 de outubro, o Baidu lançou e tornou open source um modelo que chama de Wenxin Unlimited OCR 2, o qual, segundo a empresa, elimina esse limite por completo.
A companhia descreve o lançamento como a primeira vez que um modelo alcança a análise de documentos com número arbitrário de páginas, elevando o teto de processamento de algumas dezenas de páginas para o que chama de ilimitado. Em uma demonstração, o modelo leu os sete romances de Harry Potter em uma única execução, mais de 3.600 páginas no total, mantendo alta precisão e velocidade de processamento à medida que o documento crescia.
O truque técnico é um mecanismo de atenção que a equipe chama de SR-SWA. Em vez de manter todas as páginas na memória ao mesmo tempo, o modelo funciona como uma pessoa que copia um livro longo: examina adiante, seleciona as páginas e os blocos de informação relevantes para a passagem atual e deixa o resto de lado. Um mecanismo de decodificação em blocos então monta a saída. Segundo o Baidu, essa abordagem reduziu o pico de uso do cache KV em um teste de cem páginas de 47 gigabytes para uma pequena fração disso, tornando documentos longos viáveis em hardware comum.
De acordo com a empresa, benchmarks públicos de análise de documentos com várias páginas, incluindo os muito acompanhados testes com prefixo M, colocam o modelo em resultados de ponta. O Baidu apresenta o lançamento como a chegada da era OCR 3.0, em que a análise de documentos não é medida pelo quão bem um modelo lê uma página, mas pela confiabilidade com que lida com um arquivo inteiro.
O que está em jogo é grande. Contratos, processos judiciais, prontuários médicos, arquivos históricos e bibliotecas acadêmicas chegam como pilhas de páginas digitalizadas. Um modelo capaz de absorvê-las em uma única passada poderia mudar a forma como escritórios de advocacia, hospitais e editoras digitalizam seus acervos acumulados. Também poderia alimentar documentos longos diretamente em assistentes de IA, que têm dificuldades com janelas de contexto e recuperação de informação quando precisam raciocinar sobre centenas de páginas.
Tornar o modelo open source reduz a barreira para desenvolvedores que querem criar ferramentas de documentos sem pagar taxas por página a um provedor de nuvem. O Baidu vem posicionando sua família Wenxin como base tanto para seus próprios produtos quanto para desenvolvedores externos, e liberar o modelo OCR gratuitamente se encaixa nessa estratégia.
A afirmação de páginas ilimitadas vai atrair escrutínio. Testes independentes precisarão confirmar que a precisão se mantém em digitalizações reais e bagunçadas, em escrita à mão e em tabelas, não apenas em páginas de livro limpas. Ainda assim, a demonstração é marcante: um único modelo lendo uma série completa de sete livros de uma vez é o tipo de referência concreta que costuma ficar na memória.
Para leitores globais, o lançamento é um lembrete de que os laboratórios de IA da China competem com afinco tanto em engenharia prática quanto no tamanho de modelos de destaque. A análise de documentos é um trabalho pouco glamouroso, mas está por baixo de uma enorme fatia da adoção empresarial de IA. Se o modelo entregar o que promete, o próximo campo de batalha será quem transformar primeiro a compreensão de documentos longos em ferramentas de escritório do dia a dia.