El nuevo modelo OCR de Baidu lee los siete libros de Harry Potter de una sola vez
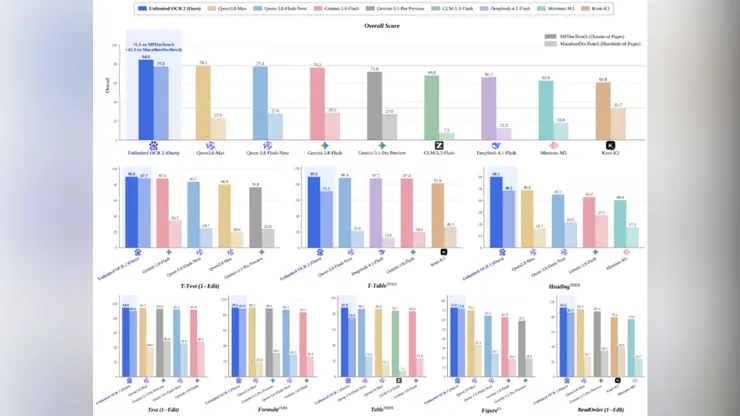
El reconocimiento óptico de caracteres, la tecnología que convierte imágenes de texto en palabras editables, lleva mucho tiempo arrastrando un techo. La mayoría de los sistemas manejan unas pocas docenas de páginas antes de que la precisión decaiga o el consumo de memoria se dispare. El 27 de octubre, Baidu publicó y liberó como código abierto un modelo al que llama Wenxin Unlimited OCR 2, que, según afirma, elimina ese límite por completo.
La compañía describe el lanzamiento como la primera vez que un modelo logra el análisis de documentos de páginas arbitrarias, llevando el techo de procesamiento de unas pocas docenas de páginas hacia lo que denomina ilimitado. En una demostración, el modelo leyó las siete novelas de Harry Potter en una sola ejecución, más de 3.600 páginas en total, manteniendo una alta precisión y velocidad de procesamiento a medida que crecía la longitud del documento.
El truco técnico es un mecanismo de atención que el equipo denomina SR-SWA. En lugar de retener todas las páginas en memoria a la vez, el modelo funciona como lo haría una persona que copia un libro extenso: escanea por delante, selecciona las páginas y los bloques de información relevantes para el pasaje actual y deja el resto a un lado. Después, un mecanismo de decodificación por fragmentos ensambla la salida. Baidu afirma que este enfoque redujo el uso máximo de la caché KV en una prueba de cien páginas de 47 gigabytes a una pequeña fracción de esa cifra, lo que hace prácticos los documentos largos en hardware convencional.
Según la compañía, los benchmarks públicos para el análisis de documentos de varias páginas, incluidos los muy seguidos tests con prefijo M, sitúan al modelo en resultados de vanguardia. Baidu presenta el lanzamiento como la llegada de la era OCR 3.0, en la que el análisis de documentos no se juzga por lo bien que un modelo lee una página, sino por la fiabilidad con que maneja un archivo entero.
Lo que está en juego es mucho. Los contratos, los expedientes judiciales, las historias clínicas, los archivos históricos y las bibliotecas académicas llegan en forma de pilas de páginas escaneadas. Un modelo capaz de ingerirlas en una sola pasada podría cambiar la forma en que los despachos de abogados, los hospitales y las editoriales digitalizan sus acumulaciones de trabajo. También podría alimentar documentos largos directamente a asistentes de IA, que han tenido dificultades con las ventanas de contexto y la recuperación cuando se les pide razonar sobre cientos de páginas.
Publicar el modelo como código abierto reduce la barrera para los desarrolladores que quieran crear herramientas documentales sin pagar tarifas por página a un proveedor de la nube. Baidu ha venido posicionando su familia Wenxin como base tanto para sus propios productos como para desarrolladores externos, y liberar gratis el modelo OCR encaja en esa estrategia.
La afirmación de páginas ilimitadas invitará al escrutinio. Pruebas independientes tendrán que confirmar que la precisión se mantiene en escaneos reales y desordenados, en escritura manuscrita y en tablas, no solo en páginas de libro limpias. Aun así, la demostración es llamativa: un solo modelo leyendo una serie completa de siete libros de una vez es el tipo de referencia concreta que tiende a perdurar.
Para los lectores globales, el lanzamiento recuerda que los laboratorios de IA de China compiten con dureza tanto en ingeniería práctica como en el tamaño de sus modelos más mediáticos. El análisis de documentos es un trabajo poco glamuroso, pero está en la base de una enorme proporción de la adopción empresarial de la IA. Si el modelo rinde como se anuncia, el próximo campo de batalla será quién convierte antes la comprensión de documentos largos en herramientas de oficina cotidianas.