Baidu's nieuwe OCR-model leest alle zeven Harry Potter-boeken in één keer
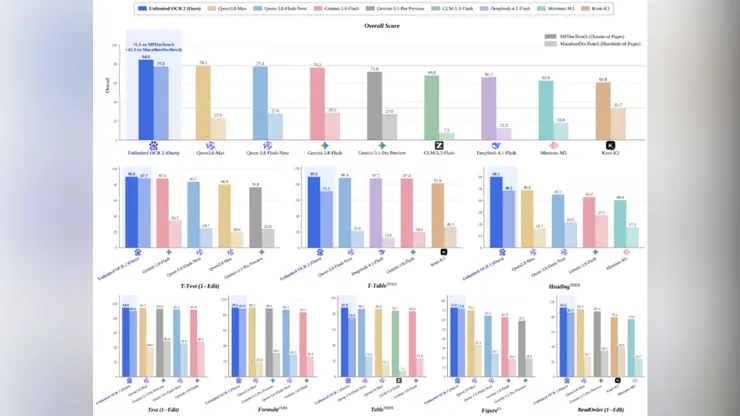
Optische tekenherkenning, de technologie die afbeeldingen van tekst omzet in bewerkbare woorden, kent al lang een plafond. De meeste systemen verwerken een paar dozijn pagina’s voordat de nauwkeurigheid afneemt of het geheugengebruik explodeert. Op 27 oktober bracht Baidu een model uit en maakte het open-source dat het Wenxin Unlimited OCR 2 noemt, en dat volgens het bedrijf die limiet volledig opheft.
Het bedrijf beschrijft de release als de eerste keer dat een model documentparsing met een willekeurig aantal pagina’s heeft bereikt, waarmee het verwerkingsplafond van tientallen pagina’s opschuift naar wat het onbeperkt noemt. In een demonstratie las het model alle zeven Harry Potter-romans in één run, in totaal meer dan 3.600 pagina’s, terwijl de hoge nauwkeurigheid en verwerkingssnelheid behouden bleven naarmate de documentlengte toenam.
De technische truc is een aandachtsmechanisme dat het team SR-SWA noemt. In plaats van elke pagina tegelijk in het geheugen te houden, werkt het model zoals iemand die een lang boek overschrijft: het kijkt vooruit, selecteert de pagina’s en informatieblokken die relevant zijn voor de huidige passage en legt de rest opzij. Een chunked decoding-mechanisme stelt vervolgens de output samen. Baidu zegt dat deze aanpak het piekgebruik van de KV-cache in een test van honderd pagina’s terugbracht van 47 gigabyte naar een kleine fractie daarvan, waardoor lange documenten haalbaar worden op gewone hardware.
Publieke benchmarks voor het parsen van documenten met meerdere pagina’s, waaronder de veelgevolgde tests met M-prefix, laten volgens het bedrijf state-of-the-art resultaten zien. Baidu presenteert de release als de komst van een OCR 3.0-tijdperk, waarin documentparsing niet wordt beoordeeld op hoe goed een model één pagina leest, maar op hoe betrouwbaar het een heel archief verwerkt.
De praktische inzet is groot. Contracten, gerechtelijke dossiers, medische dossiers, historische archieven en academische bibliotheken komen allemaal binnen als stapels gescande pagina’s. Een model dat ze in één keer kan opnemen, zou kunnen veranderen hoe advocatenkantoren, ziekenhuizen en uitgevers hun achterstanden digitaliseren. Het zou ook lange documenten rechtstreeks naar AI-assistenten kunnen voeren, die moeite hebben met contextvensters en retrieval wanneer hen wordt gevraagd over honderden pagina’s te redeneren.
Het open-source maken van het model verlaagt de drempel voor ontwikkelaars die documenttools willen bouwen zonder per pagina te betalen aan een cloudprovider. Baidu positioneert zijn Wenxin-familie als basis voor zowel eigen producten als externe ontwikkelaars, en het gratis uitbrengen van het OCR-model past bij die strategie.
De bewering van onbeperkte pagina’s zal kritisch worden bekeken. Onafhankelijke tests moeten bevestigen dat de nauwkeurigheid standhoudt bij rommelige scans uit de echte wereld, handschrift en tabellen, niet alleen bij schone boekpagina’s. Toch is de demo indrukwekkend: één model dat een hele zevendelige serie in één keer leest, is het soort concreet benchmark dat blijft hangen.
Voor wereldwijde lezers is de release een herinnering dat Chinese AI-labs hard concurreren op praktische engineering én op de modelgroottes die de krantenkoppen halen. Documentparsing is weinig glamoureus werk, maar het ligt onder een enorm aandeel van de adoptie van AI in het bedrijfsleven. Als het model presteert zoals geadverteerd, wordt het volgende slagveld wie als eerste het begrijpen van lange documenten omzet in alledaagse kantoortools.