Tencent rende open source un interprete simultaneo che batte la latenza umana
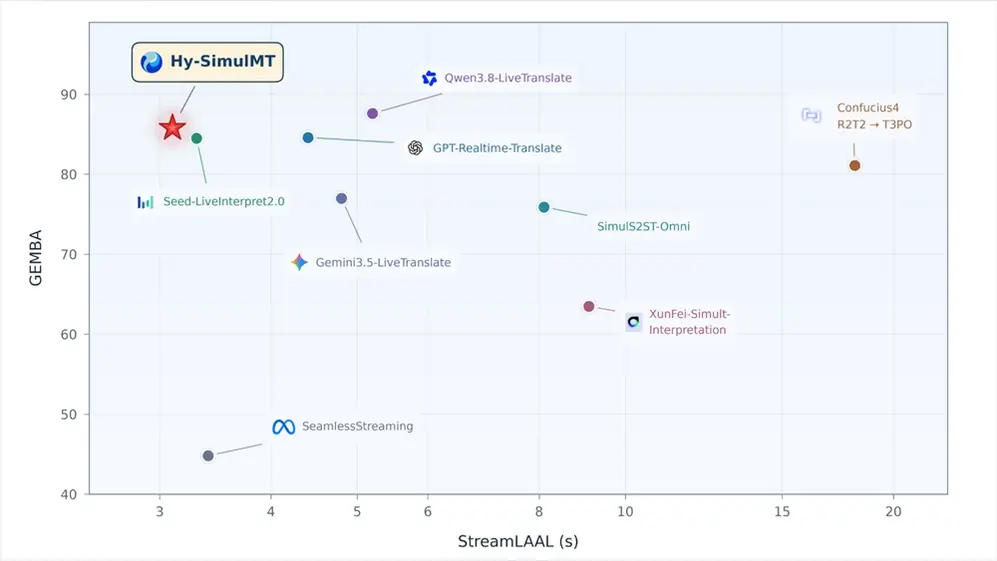
Il team di ricerca Hunyuan di Tencent ha rilasciato e reso open source il 26 ottobre un modello di traduzione simultanea chiamato Hy-SimulMT, pensato per quel tipo di interpretazione dal vivo che di norma richiede un professionista in cabina insonorizzata. Il modello riceve l’audio di un parlante e restituisce il parlato tradotto mentre la persona sta ancora parlando, passando dal cinese all’inglese e viceversa senza attendere la fine della frase.
Il dato che spicca è la latenza. Tencent afferma che il sistema risponde in circa tre secondi, contro una media di quattro o cinque secondi per gli interpreti simultanei professionisti. Nel lavoro simultaneo quei secondi sono tutto: più lungo è il ritardo, più il pubblico perde il filo e più diventa difficile per oratore e interprete restare sincronizzati. L’azienda sostiene inoltre che la qualità della traduzione raggiunge il livello degli interpreti di conferenza umani in diverse valutazioni, superando i principali modelli open source e la maggior parte delle API commerciali.
La funzione che probabilmente attirerà più attenzione fuori dagli ambienti della traduzione è la clonazione del timbro in tempo reale. Hy-SimulMT riproduce la voce e il tono del parlante nell’audio di output, così l’inglese di un parlante cinese suona come quella persona e non come una voce sintetica generica. È un passo significativo per riunioni, dirette streaming e viaggi, ma solleva anche le consuete questioni sui dati vocali e sul consenso che ogni sistema capace di clonazione porta con sé.
Tencent ha inserito il modello nella sua app di traduzione Hy come esperienza gratuita in anteprima, e il codice e i pesi sono disponibili su HuggingFace, ModelScope e GitHub. Aprire il modello invece di tenerlo dietro un’API segue un modello ormai comune tra i laboratori di AI cinesi, che spesso usano rilasci aperti per costruire ecosistemi di sviluppatori e credibilità mentre i concorrenti commerciali tengono chiusi i loro sistemi migliori.
L’interpretazione simultanea è diventata una frontiera affollata. Il problema si adatta bene all’AI perché premia la bassa latenza, l’output costante e la capacità di gestire parlato disordinato e sovrapposto, tutti ambiti in cui i grandi modelli vocali sono migliorati nettamente. È anche uno dei pochi compiti AI con un riferimento umano ovvio e misurabile: gli interpreti professionisti, la cui velocità e precisione offrono un metro di paragone comprensibile a chiunque.
Per il pubblico globale, l’effetto pratico riguarda meno la sostituzione degli interpreti e più l’ampliamento dell’accesso. Una pipeline speech-to-speech da tre secondi che gira su un telefono potrebbe rendere possibile una chiamata di lavoro, una visita in fabbrica o una conversazione in ospedale superando la barriera linguistica senza prenotare un servizio. Lo strato di clonazione vocale rende l’esperienza meno meccanica, anche se significa che la tecnologia può imitare il parlato di una persona in una lingua che non parla.
La prossima prova è l’uso nel mondo reale. Le recensioni delle app e i progetti degli sviluppatori costruiti sui pesi aperti mostreranno se la risposta in tre secondi regge su audio rumoroso, accenti marcati e lessico tecnico, dove le valutazioni di laboratorio tendono a essere indulgenti. La mossa di Tencent mette anche pressione sui concorrenti affinché pubblichino dati di latenza comparabili, il che darebbe agli acquirenti un modo più chiaro di giudicare un mercato finora guidato soprattutto da video dimostrativi.