La crisi dei benchmark AI in Cina: quando punteggi quasi perfetti non significano più nulla
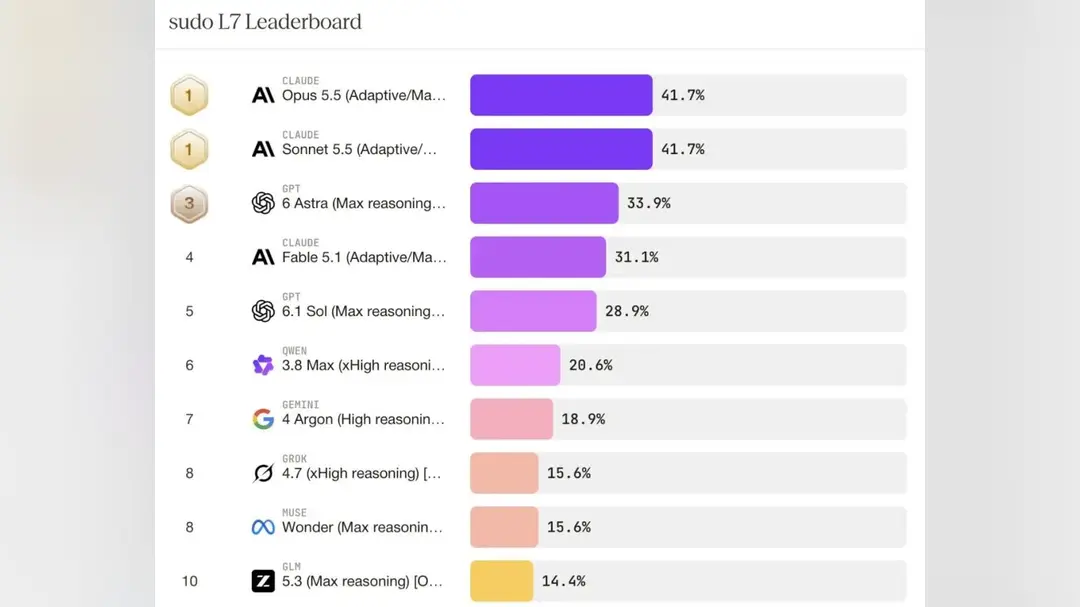
Per anni, il modo più rapido per giudicare un grande modello linguistico è stato guardare il suo punteggio su un benchmark pubblico. Nell’ottobre 2026, questa abitudine sta crollando. Secondo l’aggregatore di valutazioni di terze parti BenchLM, dei 710 benchmark monitorati al 26 ottobre, 295 sono test basati su percentuali con una copertura significativa — e 105 di essi, circa il 36%, sono ormai effettivamente saturi, con il modello in cima alla classifica che supera i 90 in ognuno.
Quando ogni modello leader si accalca al soffitto, un divario di uno o due punti non dice più a un acquirente quale sistema sia più forte. Le vecchie classifiche si avvicinano al punteggio pieno proprio mentre valutazioni più nuove e pratiche restituiscono un quadro diverso: i modelli che superano a pieni voti le domande da manuale falliscono collettivamente i test pratici. Il risultato è una rivalutazione del credito delle stesse classifiche AI, man mano che la valutazione diventa un business e le aziende che scelgono un modello iniziano a calcolare il costo per attività invece di inseguire un ranking.
Il divario tecnico dietro questo cambiamento è visibile in una ricerca recente. Un articolo prodotto congiuntamente dall’Università Tsinghua e da Zhipu AI, con Tang Jie come autore corrispondente, presenta un modello chiamato GLM-Omni. Riporta un’accuratezza del 54% nella generazione di immagini ma solo del 14,57% nella risposta a domande testuali — una divergenza che mostra come un singolo sistema possa apparire forte su una classifica e fragile su un’altra. Gli utenti dei social media hanno rapidamente collegato l’articolo a un possibile rilascio di GLM-5.5, sebbene l’articolo non confermi alcuna mappatura di versione.
Zhipu è uno degli sviluppatori di modelli AI più noti in Cina, nato da una ricerca di Tsinghua e quotato a Hong Kong. I risultati di GLM-Omni suggeriscono che il prossimo ciclo di competizione non si vincerà dominando un singolo grafico. I modelli unificati che gestiscono insieme visione e linguaggio vengono giudicati sulla loro capacità di completare effettivamente il lavoro: leggere un documento, generare un’immagine utilizzabile, rispondere a una domanda di un cliente senza allucinare.
La stessa logica sta spingendo il settore della valutazione stesso verso test più difficili. I benchmark basati su domande a scelta multipla sono economici da eseguire e facili da aggirare tramite la sovrapposizione dei dati di addestramento; i compiti agentici che richiedono a un modello di pianificare, usare strumenti e riprendersi dagli errori sono costosi e lenti ma molto più vicini a ciò per cui le imprese pagano. Il tasso di saturazione del 36% è un avvertimento che le misurazioni facili sono esaurite.
Per gli acquirenti globali, la conseguenza pratica è un cambiamento negli acquisti. Invece di chiedere quale modello sia primo in classifica, i team eseguono sempre più spesso le proprie piccole prove su flussi di lavoro reali e confrontano il costo totale, comprese le spese di inferenza e i tentativi ripetuti. I produttori di modelli cinesi, di fronte a un’intensa concorrenza sui prezzi interna, hanno un incentivo a pubblicare risultati su queste valutazioni più difficili — ma anche a selezionare quelli che vincono.
Il prossimo segnale sarà se i valutatori indipendenti riusciranno a tenere il passo. Se i benchmark saturi continueranno a dominare i titoli mentre i test pratici restano frammentati, il divario tra reputazione e risultati si allargherà — e le aziende che costruiscono i propri sistemi di valutazione saranno quelle che faranno le scommesse migliori.