Baidus neues OCR-Modell liest alle sieben Harry-Potter-Bände auf einmal
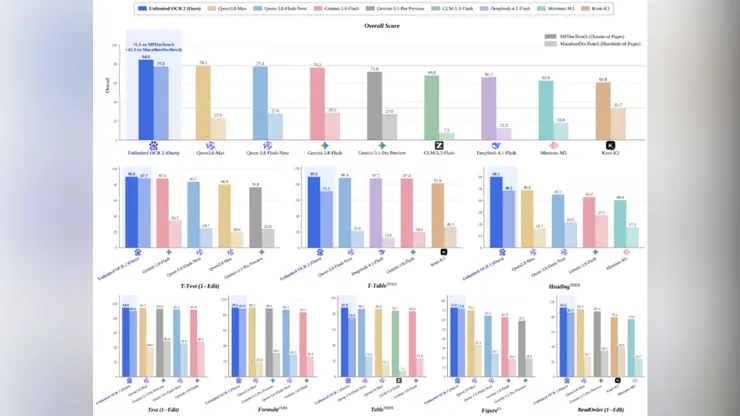
Optische Zeichenerkennung, also die Technik, die Textbilder in bearbeitbare Wörter umwandelt, stößt seit Langem an eine Obergrenze. Die meisten Systeme schaffen ein paar Dutzend Seiten, bevor die Genauigkeit nachlässt oder der Speicherbedarf explodiert. Am 27. Oktober hat Baidu ein Modell namens Wenxin Unlimited OCR 2 veröffentlicht und als Open Source freigegeben, das diese Grenze nach eigenen Angaben vollständig aufhebt.
Das Unternehmen bezeichnet die Veröffentlichung als ersten Fall, in dem ein Modell Dokumente mit beliebig vielen Seiten analysieren kann, und verschiebt damit die Verarbeitungsgrenze von einigen Dutzend Seiten hin zu dem, was es unbegrenzt nennt. In einer Demonstration las das Modell alle sieben Harry-Potter-Romane in einem einzigen Durchlauf, insgesamt mehr als 3.600 Seiten, wobei Genauigkeit und Verarbeitungsgeschwindigkeit mit wachsender Dokumentlänge hoch blieben.
Der technische Kniff ist ein Aufmerksamkeitsmechanismus, den das Team SR-SWA nennt. Statt jede Seite gleichzeitig im Speicher zu halten, arbeitet das Modell wie jemand, der ein langes Buch abschreibt: Es liest voraus, wählt die für die aktuelle Passage wichtigen Seiten und Informationsblöcke aus und legt den Rest beiseite. Ein chunked-Decoding-Mechanismus setzt die Ausgabe anschließend zusammen. Laut Baidu sank dadurch die Spitzenlast des KV-Cache in einem Test mit hundert Seiten von 47 Gigabyte auf einen kleinen Bruchteil davon, was lange Dokumente auf gewöhnlicher Hardware praktikabel macht.
Öffentliche Benchmarks zur Analyse mehrseitiger Dokumente, darunter die viel beachteten Tests mit M-Präfix, zeigen dem Unternehmen zufolge Spitzenergebnisse. Baidu rahmt die Veröffentlichung als Ankunft der OCR-3.0-Ära, in der die Dokumentanalyse nicht mehr danach beurteilt wird, wie gut ein Modell eine einzelne Seite liest, sondern wie zuverlässig es ein ganzes Archiv bewältigt.
Es steht viel auf dem Spiel. Verträge, Gerichtsakten, Krankenakten, historische Archive und wissenschaftliche Bibliotheken kommen als Stapel gescannter Seiten. Ein Modell, das sie in einem Durchgang aufnehmen kann, könnte verändern, wie Anwaltskanzleien, Kliniken und Verlage ihre Rückstände digitalisieren. Es könnte lange Dokumente auch direkt in KI-Assistenten einspeisen, die bisher mit Kontextfenstern und Retrieval Schwierigkeiten haben, wenn sie über Hunderte Seiten hinweg schlussfolgern sollen.
Die Open-Source-Freigabe senkt die Hürde für Entwickler, die Dokumentwerkzeuge bauen wollen, ohne einem Cloud-Anbieter Gebühren pro Seite zu zahlen. Baidu positioniert seine Wenxin-Familie als Grundlage sowohl für eigene Produkte als auch für externe Entwickler, und die kostenlose Freigabe des OCR-Modells passt zu dieser Strategie.
Die Behauptung unbegrenzter Seiten wird genau geprüft werden. Unabhängige Tests müssen bestätigen, dass die Genauigkeit bei unordentlichen Scans aus der Praxis, bei Handschrift und Tabellen hält, nicht nur bei sauberen Buchseiten. Dennoch ist die Demo eindrucksvoll: Ein einzelnes Modell, das eine komplette siebenteilige Reihe auf einmal liest, ist die Art konkreter Maßstab, die hängen bleibt.
Für Leser weltweit ist die Veröffentlichung ein Hinweis darauf, dass Chinas KI-Labore nicht nur bei den Schlagzeilen-Modellgrößen, sondern auch bei praktischer Ingenieursarbeit hart konkurrieren. Dokumentanalyse ist unspektakuläre Arbeit, aber sie liegt unter einem großen Teil der KI-Einführung in Unternehmen. Wenn das Modell hält, was versprochen wird, geht der nächste Wettkampf darum, wer das Verstehen langer Dokumente zuerst in alltägliche Bürowerkzeuge verwandelt.