Новая OCR-модель Baidu читает все семь книг о Гарри Поттере за один раз
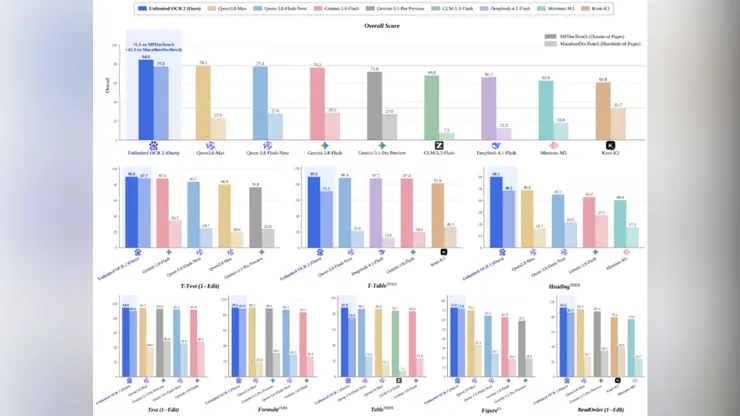
Оптическое распознавание символов (OCR) — технология, превращающая изображения текста в редактируемые слова, — долгое время имела потолок. Большинство систем справляются с несколькими десятками страниц, прежде чем точность падает или потребление памяти резко возрастает. 27 октября Baidu выпустила и открыла исходный код модели Wenxin Unlimited OCR 2, которая, по её словам, полностью снимает это ограничение.
Компания называет релиз первым случаем, когда модель достигла разбора документов произвольной длины, сдвинув потолок обработки с десятков страниц к тому, что она называет неограниченным объёмом. В демонстрации модель прочитала все семь романов о Гарри Поттере за один запуск — в общей сложности более 3600 страниц, — сохраняя высокую точность и скорость обработки по мере роста длины документа.
Техническая хитрость — механизм внимания, который команда называет SR-SWA. Вместо того чтобы удерживать в памяти все страницы сразу, модель работает так, как человек, переписывающий длинную книгу: она просматривает вперёд, выбирает страницы и информационные блоки, важные для текущего фрагмента, а остальное откладывает. Затем механизм чанкового декодирования собирает результат. Baidu утверждает, что этот подход сократил пиковое использование KV-кэша в тесте на сто страниц с 47 гигабайт до малой доли от этого, делая длинные документы практичными на обычном оборудовании.
Публичные бенчмарки для разбора многостраничных документов, включая широко отслеживаемые тесты с приставкой M, показывают, что модель достигает передовых результатов, по данным компании. Baidu представляет релиз как наступление эры OCR 3.0, в которой разбор документов оценивается не по тому, насколько хорошо модель читает одну страницу, а по тому, насколько надёжно она обрабатывает целый архив.
Практические ставки велики. Контракты, судебные дела, медицинские карты, исторические архивы и академические библиотеки — всё это поступает в виде стопок отсканированных страниц. Модель, способная поглотить их за один проход, может изменить то, как юридические фирмы, больницы и издатели оцифровывают свои накопления. Она также может напрямую передавать длинные документы в ИИ-ассистенты, которые испытывали трудности с контекстными окнами и поиском, когда их просили рассуждать на протяжении сотен страниц.
Открытие исходного кода снижает барьер для разработчиков, желающих создавать инструменты для работы с документами, не платя облачному провайдеру за каждую страницу. Baidu позиционирует семейство Wenxin как основу как для собственных продуктов, так и для сторонних разработчиков, и бесплатный выпуск OCR-модели соответствует этой стратегии.
Заявление о неограниченном количестве страниц вызовет проверку. Независимые тесты должны подтвердить, что точность сохраняется на грязных реальных сканах, рукописном тексте и таблицах, а не только на чистых книжных страницах. Тем не менее демонстрация впечатляет: одна модель, читающая целую серию из семи книг за один раз, — это тот конкретный ориентир, который обычно запоминается.
Для мировой аудитории релиз напоминает, что китайские ИИ-лаборатории активно конкурируют как в практической инженерии, так и в громких размерах моделей. Разбор документов — неблагодарная работа, но она лежит в основе огромной доли внедрения ИИ в бизнесе. Если модель работает так, как заявлено, следующей ареной станет то, кто первым превратит понимание длинных документов в повседневные офисные инструменты.