Le nouveau modèle OCR de Baidu lit les sept tomes de Harry Potter d'un seul coup
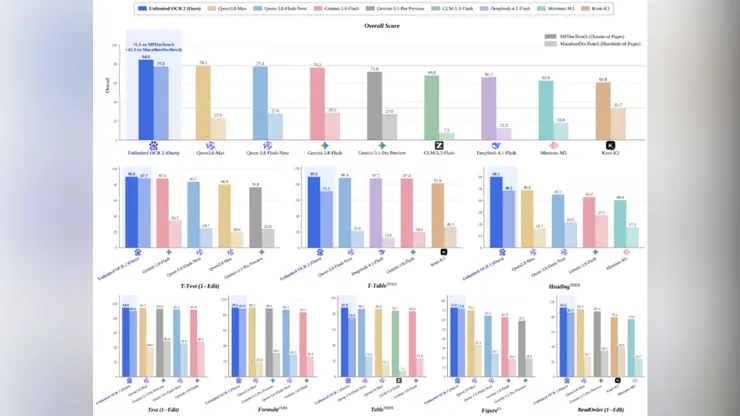
La reconnaissance optique de caractères, cette technologie qui transforme des images de texte en mots modifiables, se heurte depuis longtemps à un plafond. La plupart des systèmes traitent quelques dizaines de pages avant que la précision ne baisse ou que la mémoire ne s’envole. Le 27 octobre, Baidu a publié et placé en open source un modèle baptisé Wenxin Unlimited OCR 2, qui, selon l’entreprise, supprime totalement cette limite.
Baidu présente cette publication comme la première fois qu’un modèle parvient à analyser des documents d’un nombre arbitraire de pages, repoussant le plafond de traitement de quelques dizaines de pages vers ce qu’elle qualifie d’illimité. Lors d’une démonstration, le modèle a lu les sept romans de Harry Potter en une seule exécution, soit plus de 3 600 pages au total, en conservant une grande précision et une bonne vitesse de traitement à mesure que la longueur du document augmentait.
L’astuce technique réside dans un mécanisme d’attention que l’équipe appelle SR-SWA. Au lieu de garder toutes les pages en mémoire simultanément, le modèle fonctionne comme une personne recopiant un long livre : il balaie en avant, sélectionne les pages et les blocs d’information utiles au passage en cours et met le reste de côté. Un mécanisme de décodage par blocs assemble ensuite le résultat. Selon Baidu, cette approche a fait chuter le pic d’utilisation du cache KV lors d’un test de cent pages de 47 gigaoctets à une petite fraction de cette valeur, rendant les documents longs exploitables sur du matériel ordinaire.
D’après l’entreprise, les benchmarks publics d’analyse de documents multipages, notamment les très suivis tests à préfixe M, placent le modèle au niveau de l’état de l’art. Baidu présente ce lancement comme l’avènement de l’ère OCR 3.0, où l’analyse de documents ne se juge plus à la qualité de lecture d’une page, mais à la fiabilité avec laquelle un modèle traite une archive entière.
Les enjeux pratiques sont considérables. Contrats, dossiers judiciaires, dossiers médicaux, archives historiques et bibliothèques universitaires se présentent tous sous forme de piles de pages scannées. Un modèle capable de les ingérer en une seule passe pourrait transformer la numérisation des arriérés de travail dans les cabinets d’avocats, les hôpitaux et les maisons d’édition. Il pourrait aussi alimenter directement en documents longs les assistants d’IA, qui ont du mal avec les fenêtres de contexte et la récupération d’informations lorsqu’on leur demande de raisonner sur des centaines de pages.
La mise en open source du modèle abaisse le seuil d’entrée pour les développeurs qui veulent créer des outils documentaires sans payer de frais à la page à un fournisseur cloud. Baidu positionne sa famille Wenxin comme une base pour ses propres produits comme pour les développeurs externes, et la diffusion gratuite du modèle OCR s’inscrit dans cette stratégie.
L’affirmation de pages illimitées ne manquera pas d’être examinée de près. Des tests indépendants devront confirmer que la précision tient sur des scans réels et désordonnés, sur l’écriture manuscrite et sur les tableaux, et pas seulement sur des pages de livre bien propres. La démonstration reste néanmoins frappante : un seul modèle lisant d’une traite une série complète de sept tomes, voilà le genre de repère concret qui marque les esprits.
Pour les lecteurs du monde entier, cette publication rappelle que les laboratoires d’IA chinois livrent une concurrence acharnée sur l’ingénierie pratique autant que sur la taille des modèles à grand spectacle. L’analyse de documents est un travail peu glamour, mais elle sous-tend une part énorme de l’adoption de l’IA en entreprise. Si le modèle tient ses promesses, le prochain champ de bataille sera de savoir qui transformera le premier la compréhension des documents longs en outils de bureau du quotidien.