Tencent открывает исходный код синхронного переводчика, обгоняющего человека по задержке
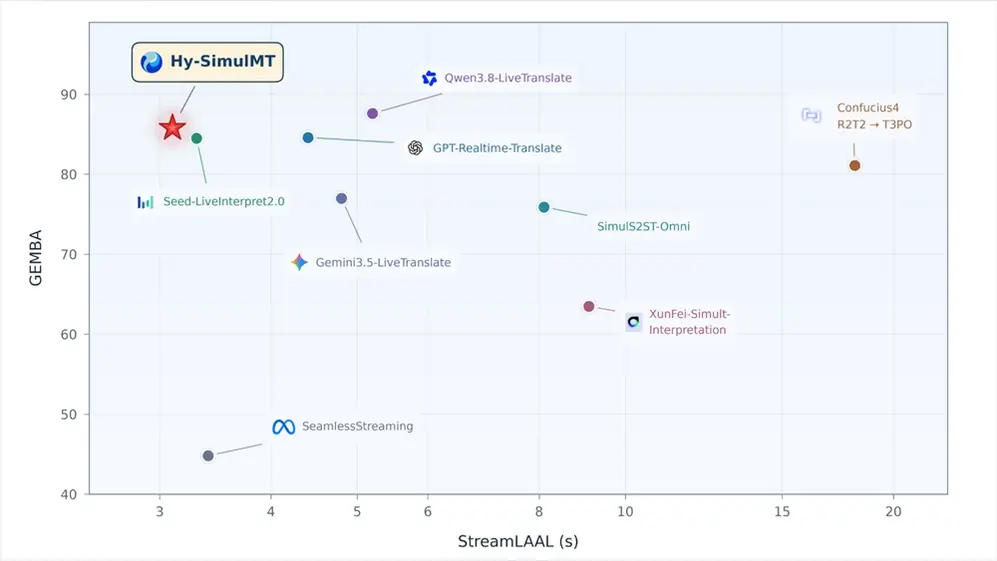
Исследовательская команда Hunyuan компании Tencent 26 октября выпустила и открыла исходный код модели синхронного перевода Hy-SimulMT, созданной для того типа устного перевода, который обычно требует обученного человека в звукоизолированной кабине. Модель принимает аудио говорящего и выдаёт переведённую речь, пока тот ещё говорит, переключаясь между китайским и английским в обоих направлениях, не дожидаясь конца предложения.
Главная цифра — задержка. Tencent утверждает, что система отвечает примерно за три секунды против в среднем четырёх-пяти секунд у профессиональных синхронных переводчиков. В синхронной работе эти секунды решают всё: чем больше отставание, тем сильнее аудитория теряет нить, и тем труднее говорящему и переводчику сохранять синхронность. Компания также заявляет, что качество её перевода на ряде оценок достигает уровня конференц-переводчиков-людей, опережая популярные открытые модели и большинство коммерческих API.
Функция, которая, вероятно, привлечёт больше всего внимания за пределами переводческой среды, — клонирование тембра в реальном времени. Hy-SimulMT воспроизводит голос и интонацию говорящего в выходном аудио, так что английская речь китайского оратора звучит как этот человек, а не как общий синтетический голос. Это значимый шаг для встреч, стримов и путешествий, но он также поднимает привычные вопросы о голосовых данных и согласии, которые вызывает любая система, способная к клонированию.
Tencent добавила модель в своё приложение для перевода Hy в качестве бесплатного ознакомительного опыта, а код и веса доступны на HuggingFace, ModelScope и GitHub. Открытие модели вместо удержания её за API следует схеме, теперь распространённой среди китайских ИИ-лабораторий, которые часто используют открытые релизы для построения экосистемы разработчиков и доверия, тогда как коммерческие конкуренты держат свои лучшие системы закрытыми.
Синхронный перевод стал оживлённым фронтиром. Эта задача хорошо подходит ИИ, потому что вознаграждает низкую задержку, стабильный вывод и умение справляться с грязной, перекрывающейся речью — во всех этих областях большие речевые модели резко улучшились. Это также одна из немногих задач ИИ с очевидным измеримым человеческим эталоном: профессиональные переводчики, чья скорость и точность дают понятную всем мерку.
Для глобальной аудитории практический эффект меньше связан с заменой переводчиков, чем с расширением доступа. Трёхсекундный конвейер речи в речь, работающий на телефоне, мог бы сделать деловой звонок, экскурсию по заводу или разговор в больнице возможными через языковой барьер без заказа услуги. Слой клонирования голоса делает опыт менее механическим, хотя также означает, что технология может имитировать речь человека на языке, которым он не владеет.
Следующая проверка — реальное использование. Отзывы в приложении и проекты разработчиков на открытых весах покажут, выдерживает ли трёхсекундный отклик шумное аудио, сильные акценты и техническую лексику, где лабораторные оценки обычно льстят модели. Шаг Tencent также давит на конкурентов, побуждая публиковать сопоставимые цифры задержки, что дало бы покупателям более ясный способ судить рынок, который до сих пор держался в основном на демонстрационных видео.