Tencent libera como código abierto un intérprete simultáneo que supera la latencia humana
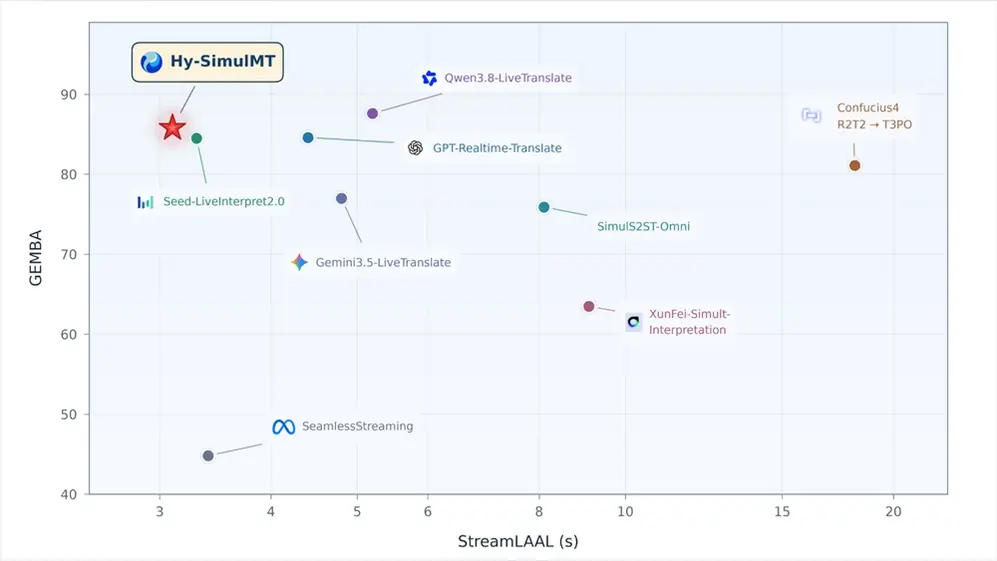
El equipo de investigación Hunyuan de Tencent publicó y liberó como código abierto el 26 de octubre un modelo de traducción simultánea llamado Hy-SimulMT, concebido para el tipo de interpretación en vivo que normalmente requiere un profesional formado en una cabina insonorizada. El modelo recibe el audio de un hablante y emite el habla traducida mientras la persona sigue hablando, alternando entre chino e inglés en ambos sentidos sin esperar a que termine la frase completa.
La cifra que encabeza el anuncio es la latencia. Tencent afirma que el sistema responde en unos tres segundos, frente a una media de cuatro a cinco segundos de los intérpretes simultáneos profesionales. En la interpretación simultánea, esos segundos lo son todo: cuanto mayor es el desfase, más pierde el hilo el público y más difícil resulta que hablante e intérprete mantengan la sincronía. La compañía también asegura que su calidad de traducción alcanza el nivel de los intérpretes de conferencias humanos en varias evaluaciones, por delante de los modelos de código abierto convencionales y de la mayoría de las API comerciales.
La función que probablemente atraerá más atención fuera del ámbito de la traducción es la clonación del timbre en tiempo real. Hy-SimulMT reproduce la voz y el tono del hablante en el audio de salida, de modo que la intervención en inglés de un hablante chino suena como esa persona y no como una voz sintética genérica. Es un avance significativo para reuniones, retransmisiones en directo y viajes, pero también plantea las conocidas cuestiones sobre los datos de voz y el consentimiento que suscita cualquier sistema capaz de clonar voces.
Tencent ha incorporado el modelo a su aplicación de traducción Hy como experiencia gratuita de acceso anticipado, y el código y los pesos están disponibles en HuggingFace, ModelScope y GitHub. Abrir el modelo en lugar de mantenerlo tras una API sigue un patrón hoy habitual entre los laboratorios de IA chinos, que a menudo recurren a las publicaciones abiertas para construir ecosistemas de desarrolladores y credibilidad mientras sus rivales comerciales mantienen cerrados sus mejores sistemas.
La interpretación simultánea se ha convertido en una frontera muy concurrida. El problema se adapta bien a la IA porque premia la baja latencia, la producción constante y la capacidad de manejar habla desordenada y superpuesta, ámbitos todos en los que los grandes modelos de voz han mejorado notablemente. Es además una de las pocas tareas de IA con una referencia humana obvia y medible: los intérpretes profesionales, cuya velocidad y precisión ofrecen una vara de medir que cualquiera puede entender.
Para el público global, el efecto práctico tiene menos que ver con sustituir a los intérpretes que con ampliar el acceso. Un sistema de voz a voz con tres segundos de latencia que funcione en un teléfono podría hacer posible una llamada de negocios, una visita a una fábrica o una conversación en un hospital a través de una barrera idiomática sin contratar un servicio. La capa de clonación de voz hace que la experiencia resulte menos mecánica, aunque también implica que la tecnología puede imitar el habla de una persona en un idioma que no habla.
La siguiente prueba es el uso en el mundo real. Las reseñas de la aplicación y los proyectos de desarrolladores construidos sobre los pesos abiertos mostrarán si la respuesta de tres segundos se mantiene con audio ruidoso, acentos marcados y vocabulario técnico, terrenos en los que las evaluaciones de laboratorio suelen favorecer al modelo. El movimiento de Tencent también presiona a sus rivales para que publiquen cifras de latencia comparables, lo que daría a los compradores una forma más clara de juzgar un mercado que hasta ahora se ha guiado sobre todo por vídeos de demostración.