Tencent abre o código de um intérprete simultâneo que supera a latência humana
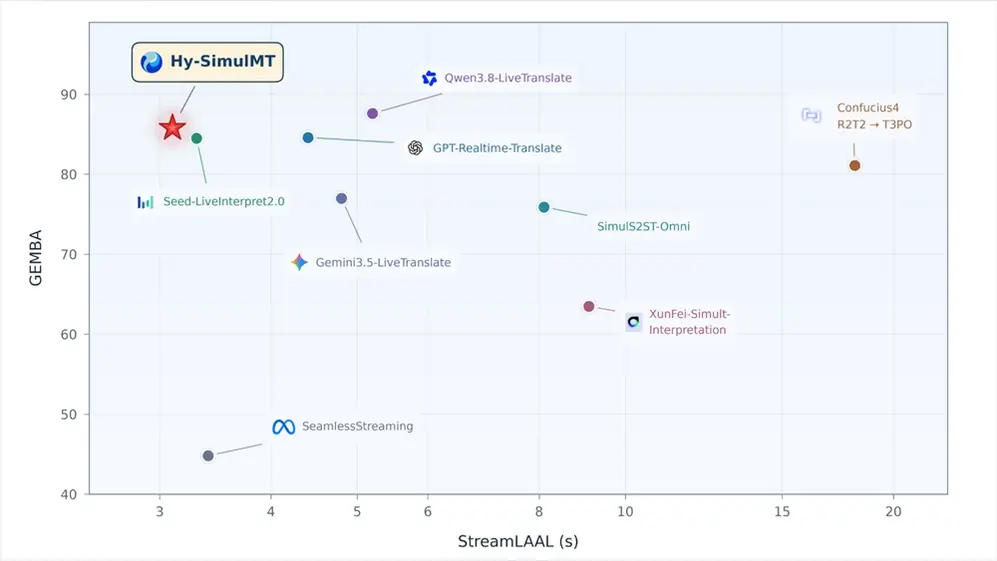
A equipe de pesquisa Hunyuan, da Tencent, lançou e abriu o código de um modelo de tradução simultânea chamado Hy-SimulMT em 26 de outubro, criado para o tipo de interpretação ao vivo que normalmente exige um profissional treinado em uma cabine à prova de som. O modelo recebe o áudio de um falante e emite a fala traduzida enquanto a pessoa ainda está falando, alternando entre chinês e inglês nos dois sentidos sem esperar que a frase inteira termine.
O número que chama atenção é a latência. A Tencent afirma que o sistema responde em cerca de três segundos, contra uma média de quatro a cinco segundos dos intérpretes simultâneos profissionais. No trabalho simultâneo, esses segundos são tudo: quanto maior o atraso, mais o público perde o fio da meada e mais difícil fica para falante e intérprete manterem a sincronia. A empresa também alega que a qualidade da tradução alcança o nível de intérpretes de conferência humanos em várias avaliações, à frente dos principais modelos de código aberto e da maioria das APIs comerciais.
O recurso que provavelmente atrairá mais atenção fora do círculo da tradução é a clonagem de timbre em tempo real. O Hy-SimulMT reproduz a voz e o tom do falante no áudio de saída, de modo que a fala em inglês de um falante chinês soa como aquela pessoa, e não como uma voz sintética genérica. É um avanço significativo para reuniões, transmissões ao vivo e viagens, mas também levanta as conhecidas questões sobre dados de voz e consentimento que qualquer sistema capaz de clonagem suscita.
A Tencent colocou o modelo em seu aplicativo de tradução Hy como experiência gratuita de prévia, e o código e os pesos estão disponíveis no HuggingFace, no ModelScope e no GitHub. Abrir o modelo em vez de mantê-lo atrás de uma API segue um padrão hoje comum entre os laboratórios de IA chineses, que costumam usar lançamentos abertos para construir ecossistemas de desenvolvedores e credibilidade, enquanto os rivais comerciais mantêm seus melhores sistemas fechados.
A interpretação simultânea se tornou uma fronteira concorrida. O problema se adapta bem à IA porque recompensa baixa latência, produção constante e capacidade de lidar com fala desordenada e sobreposta, áreas em que os grandes modelos de fala melhoraram acentuadamente. É também uma das poucas tarefas de IA com um parâmetro humano óbvio e mensurável: os intérpretes profissionais, cuja velocidade e precisão oferecem uma régua que qualquer um entende.
Para o público global, o efeito prático tem menos a ver com substituir intérpretes do que com ampliar o acesso. Um pipeline fala-a-fala de três segundos que roda em um celular poderia viabilizar uma ligação de negócios, uma visita a uma fábrica ou uma conversa em um hospital através de uma barreira linguística sem contratar um serviço. A camada de clonagem de voz torna a experiência menos mecânica, embora também signifique que a tecnologia pode imitar a fala de uma pessoa em um idioma que ela não fala.
O próximo teste é o uso no mundo real. Avaliações do aplicativo e projetos de desenvolvedores construídos sobre os pesos abertos mostrarão se a resposta de três segundos se sustenta com áudio ruidoso, sotaques fortes e vocabulário técnico, terrenos em que as avaliações de laboratório costumam favorecer o modelo. A jogada da Tencent também pressiona os rivais a publicar números de latência comparáveis, o que daria aos compradores uma forma mais clara de julgar um mercado que até agora se guia sobretudo por vídeos de demonstração.