Tencent veröffentlicht Simultandolmetscher als Open Source, der menschliche Latenz unterbietet
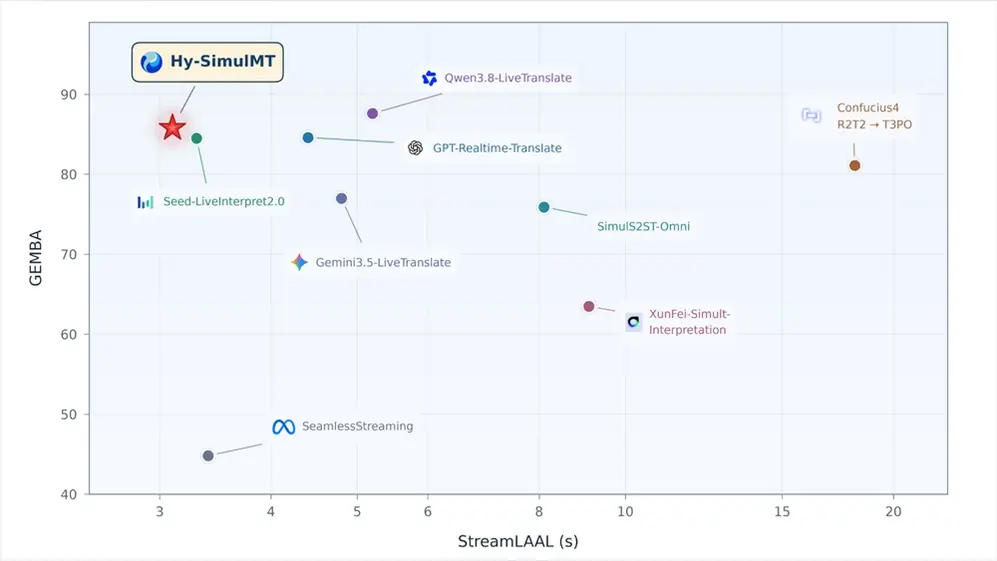
Das Forschungsteam Hunyuan von Tencent hat am 26. Oktober ein Simultandolmetsch-Modell namens Hy-SimulMT veröffentlicht und als Open Source freigegeben, das für jene Live-Verdolmetschung gedacht ist, die normalerweise eine ausgebildete Fachkraft in einer schalldichten Kabine erfordert. Das Modell nimmt das Audio eines Sprechers auf und gibt die übersetzte Sprache aus, während der Sprecher noch redet; es wechselt in beide Richtungen zwischen Chinesisch und Englisch, ohne das Ende eines vollständigen Satzes abzuwarten.
Die Schlagzeile ist die Latenz. Tencent zufolge reagiert das System in etwa drei Sekunden, gegenüber durchschnittlich vier bis fünf Sekunden bei professionellen Simultandolmetschern. Beim Simultandolmetschen entscheiden diese Sekunden über alles: Je länger die Verzögerung, desto mehr verliert das Publikum den Faden, und desto schwerer fällt es Sprecher und Dolmetscher, im Takt zu bleiben. Das Unternehmen behauptet zudem, seine Übersetzungsqualität erreiche in mehreren Evaluierungen das Niveau menschlicher Konferenzdolmetscher und liege vor gängigen Open-Source-Modellen und den meisten kommerziellen APIs.
Die Funktion, die außerhalb der Übersetzungsszene wohl die meiste Aufmerksamkeit auf sich ziehen dürfte, ist das Echtzeit-Klonen des Timbre. Hy-SimulMT bildet Stimme und Tonlage des Sprechers im Ausgangsaudio nach, sodass die englische Wiedergabe eines chinesischen Sprechers wie diese Person klingt und nicht wie eine generische synthetische Stimme. Das ist ein bedeutender Schritt für Meetings, Livestreams und Reisen, wirft aber auch die bekannten Fragen zu Stimmdaten und Einwilligung auf, die jedes klonfähige System mit sich bringt.
Tencent hat das Modell als kostenlose Vorab-Erfahrung in seine Übersetzungs-App Hy integriert; Code und Gewichte sind auf HuggingFace, ModelScope und GitHub verfügbar. Das Modell offenzulegen, statt es hinter einer API zu belassen, folgt einem Muster, das unter chinesischen KI-Laboren inzwischen üblich ist: Sie nutzen offene Veröffentlichungen, um Entwickler-Ökosysteme und Glaubwürdigkeit aufzubauen, während kommerzielle Rivalen ihre besten Systeme geschlossen halten.
Simultandolmetschen ist zu einer viel umkämpften Front geworden. Das Problem passt gut zur KI, weil es niedrige Latenz, gleichmäßige Ausgabe und den Umgang mit unordentlicher, überlappender Sprache belohnt – alles Bereiche, in denen große Sprachmodelle deutlich zugelegt haben. Es ist zudem eine der wenigen KI-Aufgaben mit einem offensichtlichen, messbaren menschlichen Maßstab: professionelle Dolmetscher, deren Tempo und Genauigkeit einen für jeden verständlichen Richtwert liefern.
Für ein globales Publikum geht es praktisch weniger um das Ersetzen von Dolmetschern als um einen breiteren Zugang. Eine dreisekündige Speech-to-Speech-Pipeline, die auf einem Telefon läuft, könnte einen Geschäftsanruf, einen Rundgang durch eine Fabrik oder ein Gespräch im Krankenhaus über die Sprachbarriere hinweg ermöglichen, ohne einen Dienst buchen zu müssen. Die Stimmlkonungsschicht lässt das Erlebnis weniger mechanisch wirken, bedeutet aber auch, dass die Technologie die Sprache einer Person in einer Sprache nachahmen kann, die sie nicht spricht.
Der nächste Test ist der Praxiseinsatz. App-Rezensionen und Entwicklerprojekte auf Basis der offenen Gewichte werden zeigen, ob die Drei-Sekunden-Reaktion bei lauten Audios, starken Akzenten und Fachvokabular standhält – Bereichen, in denen Laborevaluierungen ein Modell gern schmeicheln. Tencents Schritt setzt zudem die Rivalen unter Druck, vergleichbare Latenzwerte zu veröffentlichen, was Käufern eine klarere Beurteilung eines Marktes ermöglichen würde, der bislang vor allem von Demo-Videos lebt.