Tencent maakt simultaantolk open source die menselijke latentie verslaat
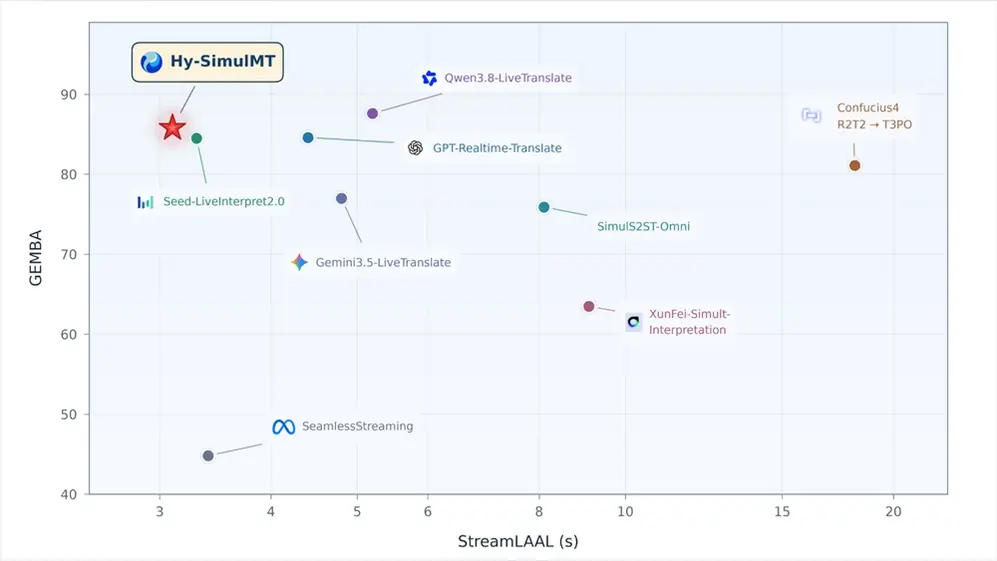
Het Hunyuan-onderzoeksteam van Tencent heeft op 26 oktober een simultaanvertaalmodel genaamd Hy-SimulMT uitgebracht en open source gemaakt, bedoeld voor het soort live tolken waarvoor normaal een getrainde mens in een geluiddichte cabine nodig is. Het model neemt audio van een spreker en levert vertaalde spraak terwijl de spreker nog aan het woord is, en schakelt tussen Chinees en Engels in beide richtingen zonder te wachten tot een volledige zin is afgerond.
Het opvallendste cijfer is de latentie. Volgens Tencent reageert het systeem in ongeveer drie seconden, tegenover gemiddeld vier tot vijf seconden voor professionele simultaantolken. Bij simultaanwerk zijn die seconden allesbepalend: hoe langer de vertraging, hoe meer het publiek de draad kwijtraakt en hoe moeilijker spreker en tolk synchroon blijven. Het bedrijf claimt bovendien dat de vertaalkwaliteit bij verschillende evaluaties het niveau van menselijke conferentietolken haalt, voor op gangbare opensourcemodellen en de meeste commerciële API’s.
De functie die buiten tolkringen waarschijnlijk de meeste aandacht trekt, is realtime timbrekloning. Hy-SimulMT reproduceert de stem en toon van de spreker in de uitvoeraudio, zodat het Engels van een Chinese spreker klinkt als die persoon en niet als een generieke synthetische stem. Dat is een betekenisvolle stap voor vergaderingen, livestreams en reizen, maar het roept ook de bekende vragen op over stemdata en toestemming die elk systeem met kloningsvermogen oproept.
Tencent heeft het model in zijn Hy-vertaalapp gezet als gratis eerste kennismaking, en de code en gewichten zijn beschikbaar op HuggingFace, ModelScope en GitHub. Het model openstellen in plaats van achter een API te houden volgt een patroon dat nu gangbaar is onder Chinese AI-labs, die open releases vaak gebruiken om ontwikkelaarsecosystemen en geloofwaardigheid op te bouwen terwijl commerciële rivalen hun beste systemen gesloten houden.
Simultaan tolken is een druk bevochten front geworden. Het probleem past goed bij AI omdat het lage latentie, stabiele output en het vermogen om rommelige, overlappende spraak te verwerken beloont, allemaal gebieden waar grote spraakmodellen sterk zijn verbeterd. Het is ook een van de weinige AI-taken met een duidelijke, meetbare menselijke benchmark: professionele tolken, wier snelheid en nauwkeurigheid een maatstaf bieden die iedereen begrijpt.
Voor een wereldwijd publiek gaat het praktische effect minder over het vervangen van tolken dan over het verruimen van toegang. Een spraak-naar-spraakpijplijn van drie seconden die op een telefoon draait, kan een zakelijk gesprek, een rondleiding in een fabriek of een gesprek in een ziekenhuis mogelijk maken over een taalbarrière heen zonder een dienst te boeken. De stemkloningslaag maakt de ervaring minder mechanisch, al betekent het ook dat de technologie iemands spraak kan imiteren in een taal die die persoon niet spreekt.
De volgende test is gebruik in de echte wereld. Apprecensies en ontwikkelaarsprojecten op basis van de open gewichten zullen laten zien of de reactie van drie seconden standhoudt bij rumoerige audio, sterke accenten en technisch vocabulaire, waar labevaluaties een model doorgaans gunstig uitpakken. De zet van Tencent zet ook rivalen onder druk om vergelijkbare latentiecijfers te publiceren, wat kopers een duidelijker manier zou geven om een markt te beoordelen die tot nu toe vooral op demovideo’s draait.