La crise des benchmarks de l'IA en Chine : quand des scores quasi parfaits ne veulent plus rien dire
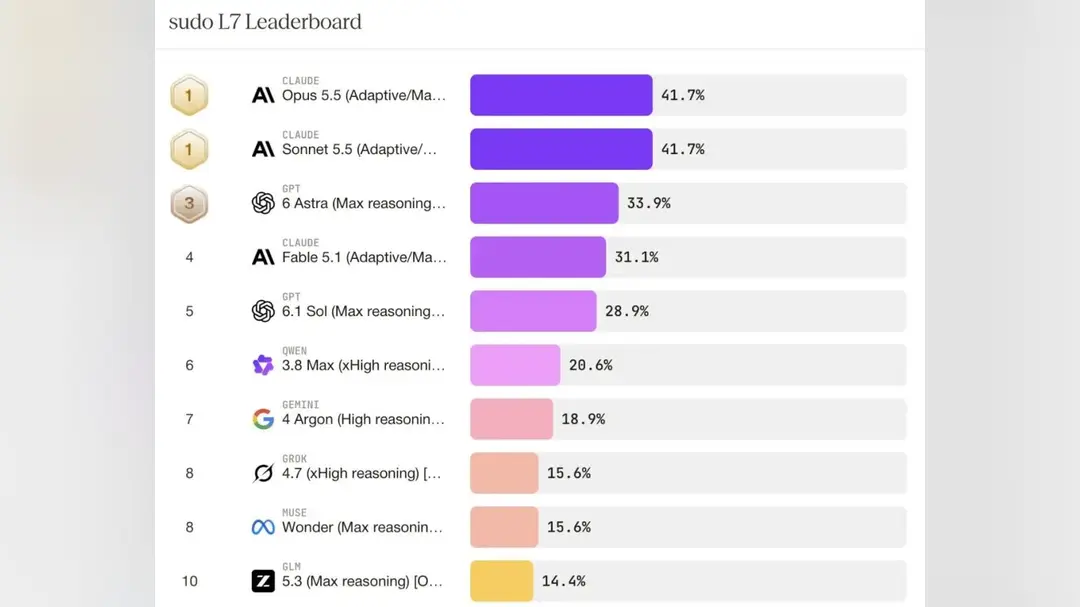
Pendant des années, le moyen le plus rapide de juger un grand modèle de langage était de consulter son score sur un benchmark public. En octobre 2026, cette habitude se délite. Selon l’agrégateur d’évaluations tiers BenchLM, sur les 710 benchmarks qu’il suit au 26 octobre, 295 sont des tests en pourcentage avec une couverture significative — et 105 d’entre eux, soit environ 36 %, sont désormais effectivement saturés, le modèle le mieux classé dépassant 90 dans chacun d’eux.
Quand tous les modèles de tête se pressent au plafond, un écart d’un ou deux points ne dit plus à un acheteur quel système est le plus fort. Les anciens classements approchent de la note maximale au moment même où des évaluations plus récentes et plus pratiques dressent un tableau différent : les modèles qui excellent aux questions de manuel échouent collectivement aux tests pratiques. Il en résulte une réévaluation de la crédibilité des classements d’IA eux-mêmes, à mesure que l’évaluation devient une activité commerciale et que les entreprises qui choisissent un modèle se mettent à calculer le coût par tâche plutôt qu’à courir après un rang.
L’écart technique qui sous-tend ce changement est visible dans des recherches récentes. Un article produit conjointement par l’Université Tsinghua et Zhipu AI, avec Tang Jie comme auteur correspondant, présente un modèle appelé GLM-Omni. Il rapporte une précision de 54 % en génération d’images mais de seulement 14,57 % en réponse à des questions textuelles — une dissociation qui montre comment un même système peut paraître solide sur un classement et fragile sur un autre. Les internautes ont rapidement associé l’article à une éventuelle sortie de GLM-5.5, bien que l’article ne confirme aucune correspondance de version.
Zhipu est l’un des développeurs de modèles d’IA les plus connus de Chine, issu de la recherche de Tsinghua et coté à Hong Kong. Les résultats de GLM-Omni suggèrent que la prochaine manche de compétition ne se gagnera pas en coiffant un seul tableau. Les modèles unifiés qui traitent ensemble vision et langage sont jugés sur leur capacité à accomplir réellement un travail : lire un document, générer une image utilisable, répondre à la question d’un client sans halluciner.
La même logique pousse l’industrie de l’évaluation elle-même vers des tests plus difficiles. Les benchmarks fondés sur des questions à choix multiples sont peu coûteux à exécuter et faciles à manipuler par recouvrement des données d’entraînement ; les tâches agentiques qui exigent d’un modèle qu’il planifie, utilise des outils et se remette d’erreurs sont coûteuses et lentes, mais bien plus proches de ce que paient les entreprises. Le taux de saturation de 36 % est un avertissement : les mesures faciles sont épuisées.
Pour les acheteurs mondiaux, la conséquence pratique est un changement dans les achats. Au lieu de demander quel modèle est premier, les équipes mènent de plus en plus leurs propres petits essais sur des flux de travail réels et comparent le coût total, y compris les frais d’inférence et les nouvelles tentatives. Les créateurs de modèles chinois, confrontés à une intense concurrence sur les prix au niveau national, ont intérêt à publier des résultats sur ces évaluations plus difficiles — mais aussi à sélectionner celles qu’ils gagnent.
Le prochain signal sera de savoir si les évaluateurs indépendants peuvent suivre le rythme. Si les benchmarks saturés continuent de dominer les gros titres tandis que les tests pratiques restent fragmentés, l’écart entre réputation et livraison se creusera — et les entreprises qui construisent leurs propres outils d’évaluation seront celles qui font les meilleurs paris.