Кризис ИИ-бенчмарков в Китае: когда почти идеальные результаты перестают что-либо значить
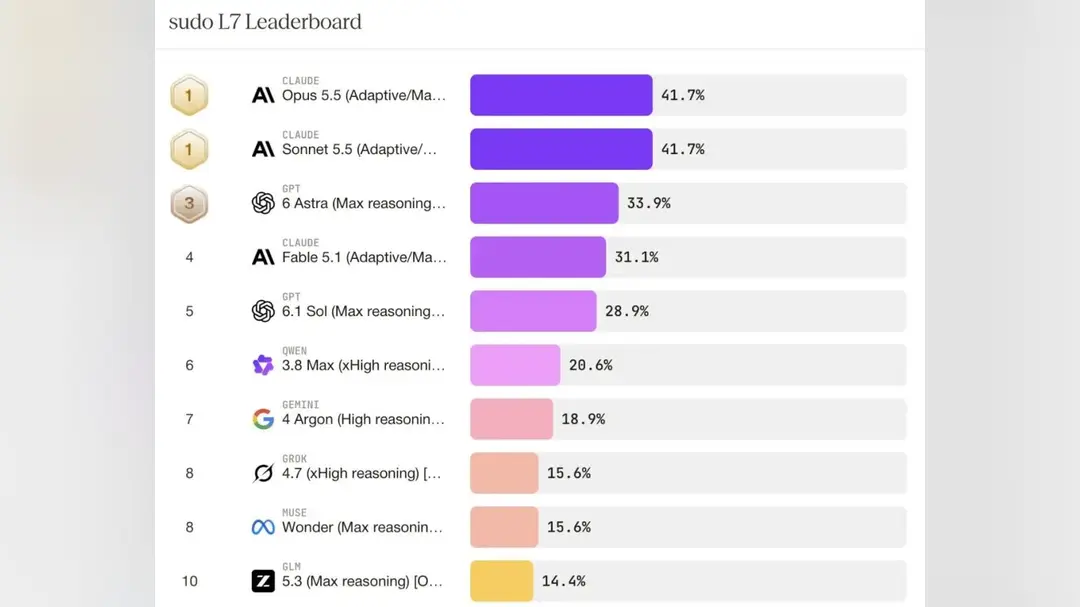
Долгие годы самый быстрый способ оценить большую языковую модель состоял в том, чтобы посмотреть на её результат в публичном бенчмарке. В октябре 2026 года эта привычка рушится. По данным стороннего агрегатора оценок BenchLM, из 710 бенчмарков, которые он отслеживает по состоянию на 26 октября, 295 представляют собой процентные тесты с осмысленным покрытием — и 105 из них, примерно 36%, сейчас фактически насыщены: модель-лидер набирает выше 90 в каждом из них.
Когда все ведущие модели теснятся у потолка, разрыв в один-два балла больше не говорит покупателю, какая система сильнее. Старые таблицы лидеров приближаются к максимальным оценкам как раз тогда, когда новые, более практичные оценки рисуют иную картину: модели, которые блестяще отвечают на учебные вопросы, коллективно проваливают практические тесты. Результат — переоценка самих рейтингов ИИ, поскольку оценка превращается в бизнес, а компании, выбирающие модель, начинают считать стоимость выполнения задачи вместо погони за местом в рейтинге.
Технический разрыв, стоящий за этим сдвигом, виден в свежем исследовании. Статья, подготовленная совместно Университетом Цинхуа и Zhipu AI, где Тан Цзе является автором-корреспондентом, представляет модель под названием GLM-Omni. В ней сообщается о точности 54% в генерации изображений, но лишь 14,57% в ответах на текстовые вопросы — разрыв, показывающий, как одна система может выглядеть сильной в одной таблице лидеров и хрупкой в другой. Пользователи соцсетей быстро связали статью с возможным выпуском GLM-5.5, хотя статья не подтверждает никакого соответствия версий.
Zhipu — один из самых известных китайских разработчиков ИИ-моделей, выделившийся из исследований Цинхуа и котирующийся в Гонконге. Результаты GLM-Omni говорят о том, что следующий раунд конкуренции не будет выигран за счёт вершины одного графика. Унифицированные модели, работающие с изображением и языком вместе, оцениваются по тому, способны ли они реально выполнить работу: прочитать документ, сгенерировать пригодное изображение, ответить на вопрос клиента без галлюцинаций.
Та же логика подталкивает саму индустрию оценки к более сложным тестам. Бенчмарки на основе вопросов с множественным выбором дешевы в проведении и легко поддаются накрутке через пересечение обучающих данных; агентные задачи, требующие от модели планировать, использовать инструменты и восстанавливаться после ошибок, дороги и медленны, но гораздо ближе к тому, за что платят предприятия. Уровень насыщения в 36% — предупреждение о том, что лёгкие измерения исчерпаны.
Для глобальных покупателей практическое следствие — изменение в закупках. Вместо вопроса о том, какая модель занимает первое место, команды всё чаще проводят собственные небольшие испытания на реальных рабочих процессах и сравнивают совокупную стоимость, включая расходы на инференс и повторные попытки. Китайские разработчики моделей, сталкиваясь с жёсткой внутренней ценовой конкуренцией, заинтересованы публиковать результаты в этих более сложных оценках — но также и отбирать те, в которых они побеждают.
Следующий сигнал — смогут ли независимые оценщики не отставать. Если насыщенные бенчмарки продолжат доминировать в заголовках, а практические тесты останутся разрозненными, разрыв между репутацией и реальной отдачей будет расти — и компании, создающие собственные системы оценки, будут делать более удачные ставки.