Chinas KI-Benchmark-Krise: Wenn nahezu perfekte Werte nichts mehr bedeuten
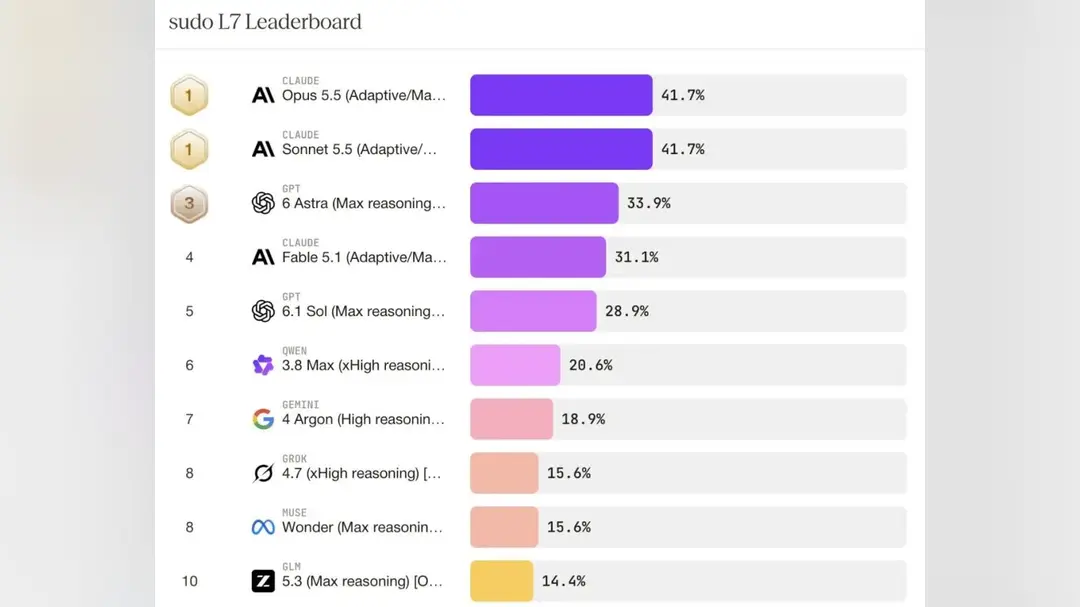
Jahrelang war der schnellste Weg, ein großes Sprachmodell zu beurteilen, ein Blick auf seinen Wert in einem öffentlichen Benchmark. Im Oktober 2026 bricht diese Gewohnheit zusammen. Laut dem Drittanbieter-Evaluierungsaggregator BenchLM sind von den 710 Benchmarks, die er mit Stand vom 26. Oktober verfolgt, 295 prozentbasierte Tests mit aussagekräftiger Abdeckung – und 105 davon, rund 36 %, sind inzwischen effektiv gesättigt, wobei das bestplatzierte Modell bei jedem einzelnen über 90 liegt.
Wenn sich alle führenden Modelle an der Decke drängen, sagt eine Lücke von ein oder zwei Punkten einem Käufer nicht mehr, welches System stärker ist. Die alten Ranglisten nähern sich der vollen Punktzahl, gerade während neuere, praxisnähere Bewertungen ein anderes Bild ergeben: Modelle, die bei den Lehrbuchfragen glänzen, scheitern kollektiv an den Praxistests. Das Ergebnis ist eine Neubewertung der Glaubwürdigkeit von KI-Ranglisten selbst, da die Evaluation zum Geschäft wird und Unternehmen bei der Modellwahl beginnen, die Kosten pro Aufgabe zu berechnen, statt einem Rang nachzujagen.
Die technische Kluft hinter diesem Wandel zeigt sich in frischer Forschung. Ein gemeinsam von der Tsinghua-Universität und Zhipu AI erstelltes Papier mit Tang Jie als korrespondierendem Autor stellt ein Modell namens GLM-Omni vor. Es berichtet 54 % Genauigkeit bei der Bilderzeugung, aber nur 14,57 % bei der Beantwortung von Textfragen – eine Diskrepanz, die zeigt, wie ein einzelnes System auf einer Rangliste stark und auf einer anderen fragil wirken kann. Nutzer sozialer Medien brachten das Papier schnell mit einer möglichen Veröffentlichung von GLM-5.5 in Verbindung, obwohl das Papier keine Versionszuordnung bestätigt.
Zhipu ist einer der bekanntesten KI-Modellentwickler Chinas, hervorgegangen aus der Tsinghua-Forschung und in Hongkong börsennotiert. Die GLM-Omni-Ergebnisse legen nahe, dass die nächste Wettbewerbsrunde nicht durch das Anführen einer einzelnen Tabelle gewonnen wird. Einheitliche Modelle, die Vision und Sprache gemeinsam verarbeiten, werden daran gemessen, ob sie tatsächlich Arbeit erledigen können: ein Dokument lesen, ein brauchbares Bild erzeugen, eine Kundenfrage beantworten, ohne zu halluzinieren.
Dieselbe Logik treibt die Evaluierungsbranche selbst zu härteren Tests. Benchmarks auf Basis von Multiple-Choice-Fragen sind billig durchzuführen und durch Überschneidungen mit Trainingsdaten leicht zu manipulieren; agentische Aufgaben, bei denen ein Modell planen, Werkzeuge nutzen und sich von Fehlern erholen muss, sind teuer und langsam, aber viel näher an dem, wofür Unternehmen zahlen. Die Sättigungsrate von 36 % ist eine Warnung, dass die einfachen Messungen aufgebraucht sind.
Für globale Käufer besteht die praktische Konsequenz in einer Veränderung der Beschaffung. Statt zu fragen, welches Modell an erster Stelle steht, führen Teams zunehmend eigene kleine Tests an realen Arbeitsabläufen durch und vergleichen die Gesamtkosten, einschließlich Inferenzgebühren und Wiederholungen. Chinesische Modellentwickler haben angesichts des intensiven inländischen Preiswettbewerbs einen Anreiz, Ergebnisse zu diesen härteren Bewertungen zu veröffentlichen – aber auch, sich diejenigen herauszupicken, die sie gewinnen.
Das nächste Signal wird sein, ob unabhängige Evaluatoren Schritt halten können. Wenn gesättigte Benchmarks weiterhin die Schlagzeilen dominieren, während praktische Tests zersplittert bleiben, wird die Lücke zwischen Ruf und Lieferung größer – und die Unternehmen, die ihre eigenen Evaluierungsinstrumente bauen, werden diejenigen sein, die die besseren Wetten eingehen.