A crise dos benchmarks de IA na China: quando pontuações quase perfeitas deixam de significar algo
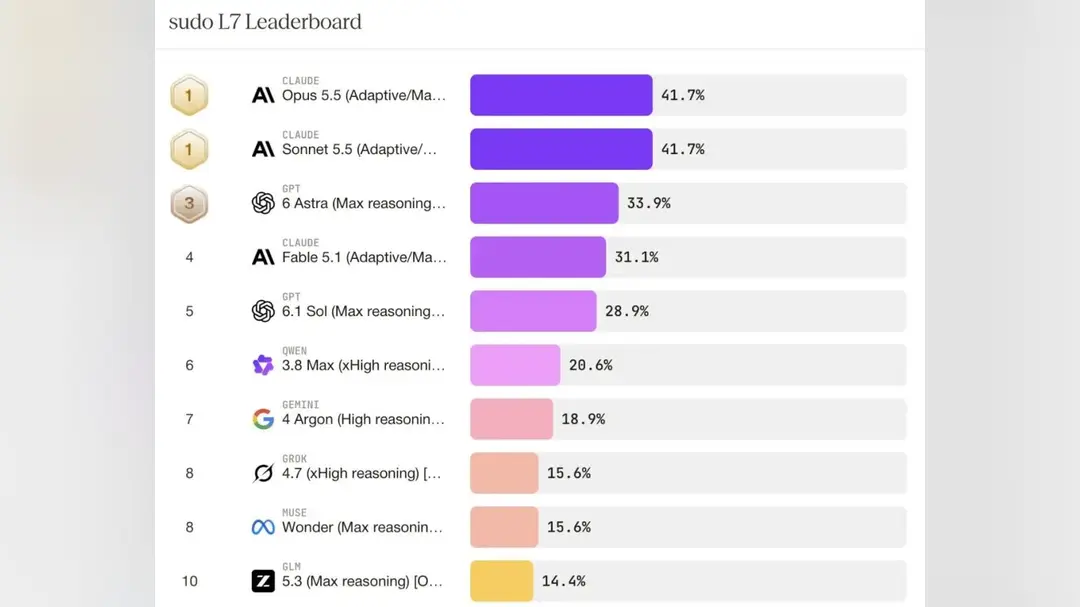
Durante anos, a maneira mais rápida de avaliar um grande modelo de linguagem era olhar sua pontuação em um benchmark público. Em outubro de 2026, esse hábito está se desfazendo. Segundo o agregador de avaliações independente BenchLM, dos 710 benchmarks que acompanha em 26 de outubro, 295 são testes baseados em porcentagem com cobertura significativa — e 105 deles, cerca de 36%, estão agora efetivamente saturados, com o modelo mais bem colocado ultrapassando 90 em todos eles.
Quando todos os modelos líderes se aglomeram no teto, uma diferença de um ou dois pontos já não diz ao comprador qual sistema é mais forte. As antigas tabelas de classificação se aproximam da nota máxima justamente quando avaliações mais novas e práticas produzem um quadro diferente: os modelos que arrasam nas perguntas de livro didático falham coletivamente nos testes práticos. O resultado é uma reavaliação da credibilidade dos próprios rankings de IA, à medida que a avaliação se torna um negócio e as empresas que escolhem um modelo passam a calcular o custo por tarefa em vez de perseguir uma posição.
A lacuna técnica por trás dessa mudança é visível em pesquisas recentes. Um artigo produzido em conjunto pela Universidade Tsinghua e pela Zhipu AI, com Tang Jie como autor correspondente, apresenta um modelo chamado GLM-Omni. Ele relata 54% de precisão em geração de imagens, mas apenas 14,57% em resposta a perguntas de texto — uma divisão que mostra como um único sistema pode parecer forte em uma tabela de classificação e frágil em outra. Usuários de redes sociais rapidamente associaram o artigo a um possível lançamento do GLM-5.5, embora o artigo não confirme nenhum mapeamento de versão.
A Zhipu é uma das desenvolvedoras de modelos de IA mais conhecidas da China, originada da pesquisa da Tsinghua e listada em Hong Kong. Os resultados do GLM-Omni sugerem que a próxima rodada de competição não será vencida liderando um único gráfico. Modelos unificados que lidam com visão e linguagem juntos estão sendo avaliados por sua capacidade de realmente concluir trabalho: ler um documento, gerar uma imagem utilizável, responder à pergunta de um cliente sem alucinar.
A mesma lógica está empurrando a própria indústria de avaliação para testes mais difíceis. Benchmarks baseados em perguntas de múltipla escolha são baratos de executar e fáceis de manipular por meio de sobreposição com dados de treinamento; tarefas agênticas que exigem que um modelo planeje, use ferramentas e se recupere de erros são caras e lentas, mas muito mais próximas do que as empresas pagam. A taxa de saturação de 36% é um alerta de que as medições fáceis se esgotaram.
Para compradores globais, a consequência prática é uma mudança nas compras. Em vez de perguntar qual modelo está em primeiro lugar, as equipes realizam cada vez mais seus próprios pequenos testes em fluxos de trabalho reais e comparam o custo total, incluindo taxas de inferência e novas tentativas. Os criadores de modelos chineses, diante de intensa concorrência de preços doméstica, têm incentivo para publicar resultados nessas avaliações mais difíceis — mas também para escolher a dedo aquelas em que vencem.
O próximo sinal será se os avaliadores independentes conseguem acompanhar o ritmo. Se benchmarks saturados continuarem dominando as manchetes enquanto os testes práticos permanecem fragmentados, a lacuna entre reputação e entrega vai aumentar — e as empresas que construírem seus próprios sistemas de avaliação serão as que farão as melhores apostas.