La crisis de los benchmarks de IA en China: cuando las puntuaciones casi perfectas dejan de significar algo
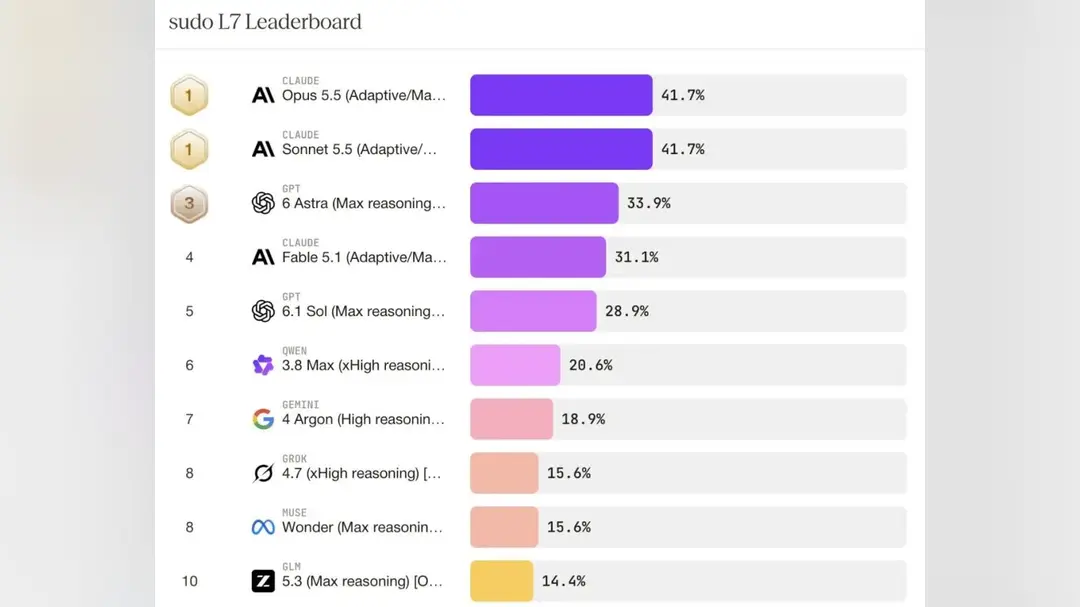
Durante años, la forma más rápida de juzgar un gran modelo de lenguaje era consultar su puntuación en un benchmark público. En octubre de 2026, esa costumbre se está desmoronando. Según el agregador de evaluaciones independiente BenchLM, de los 710 benchmarks que rastrea a fecha del 26 de octubre, 295 son pruebas basadas en porcentajes con una cobertura significativa, y 105 de ellos, aproximadamente el 36%, están ahora efectivamente saturados, con el modelo mejor clasificado superando los 90 puntos en todos ellos.
Cuando todos los modelos líderes se agolpan en el techo, una diferencia de uno o dos puntos ya no indica al comprador qué sistema es más potente. Las viejas tablas de clasificación se acercan a la nota máxima justo cuando las evaluaciones más nuevas y prácticas ofrecen una imagen distinta: los modelos que arrasan en las preguntas de libro de texto fallan colectivamente en las pruebas prácticas. El resultado es una reevaluación de la credibilidad de los propios rankings de IA, a medida que la evaluación se convierte en un negocio y las empresas que eligen un modelo empiezan a calcular el coste por tarea en lugar de perseguir una posición.
La brecha técnica que subyace a este cambio se aprecia en una investigación reciente. Un artículo elaborado conjuntamente por la Universidad de Tsinghua y Zhipu AI, con Tang Jie como autor correspondiente, presenta un modelo llamado GLM-Omni. Reporta una precisión del 54% en generación de imágenes pero solo del 14,57% en respuesta a preguntas de texto, una brecha que muestra cómo un mismo sistema puede parecer sólido en una tabla de clasificación y frágil en otra. Los usuarios de redes sociales vincularon rápidamente el artículo con un posible lanzamiento de GLM-5.5, aunque el artículo no confirma ninguna correspondencia de versión.
Zhipu es uno de los desarrolladores de modelos de IA más conocidos de China, surgido de la investigación de Tsinghua y cotizado en Hong Kong. Los resultados de GLM-Omni sugieren que la próxima ronda de competencia no se ganará encabezando una sola tabla. Los modelos unificados que manejan visión y lenguaje a la vez se juzgan por si pueden completar trabajo real: leer un documento, generar una imagen utilizable, responder a la pregunta de un cliente sin alucinar.
La misma lógica está empujando a la propia industria de la evaluación hacia pruebas más duras. Los benchmarks basados en preguntas de opción múltiple son baratos de ejecutar y fáciles de manipular mediante solapamiento con los datos de entrenamiento; las tareas agénticas que exigen que un modelo planifique, use herramientas y se recupere de errores son caras y lentas, pero mucho más cercanas a lo que pagan las empresas. La tasa de saturación del 36% es una advertencia de que las mediciones fáciles se han agotado.
Para los compradores globales, la consecuencia práctica es un cambio en la contratación. En lugar de preguntar qué modelo ocupa el primer puesto, los equipos realizan cada vez más sus propias pruebas pequeñas sobre flujos de trabajo reales y comparan el coste total, incluidas las tarifas de inferencia y los reintentos. Los creadores de modelos chinos, ante una intensa competencia de precios interna, tienen incentivos para publicar resultados en estas evaluaciones más duras, pero también para seleccionar solo aquellas en las que ganan.
La próxima señal será si los evaluadores independientes pueden mantener el ritmo. Si los benchmarks saturados siguen dominando los titulares mientras las pruebas prácticas permanecen fragmentadas, la brecha entre reputación y entrega se ampliará, y las empresas que construyan sus propios sistemas de evaluación serán las que hagan las mejores apuestas.