De AI-benchmarkcrisis in China: wanneer bijna perfecte scores niets meer betekenen
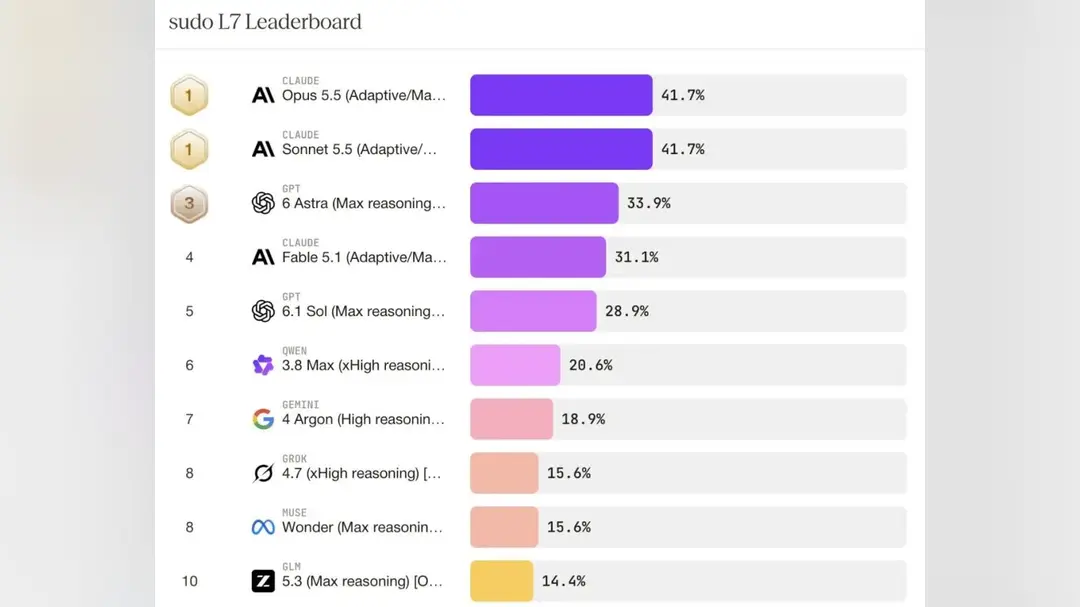
Jarenlang was de snelste manier om een groot taalmodel te beoordelen het bekijken van de score op een publieke benchmark. In oktober 2026 brokkelt die gewoonte af. Volgens de externe evaluatie-aggregator BenchLM zijn van de 710 benchmarks die hij per 26 oktober volgt, er 295 op percentages gebaseerde tests met een betekenisvolle dekking — en 105 daarvan, ongeveer 36%, zijn nu effectief verzadigd, waarbij het best gerangschikte model op elk daarvan boven de 90 scoort.
Wanneer elk toonaangevend model tegen het plafond zit, zegt een verschil van een of twee punten een koper niet meer welk systeem sterker is. De oude ranglijsten naderen volle punten net nu nieuwere, praktischere evaluaties een ander beeld opleveren: modellen die de schoolboekvragen glansrijk doorstaan, falen collectief op de praktijktests. Het resultaat is een herbeoordeling van de kredietwaardigheid van AI-ranglijsten zelf, nu evaluatie een business wordt en bedrijven die een model kiezen de kosten per taak gaan berekenen in plaats van een rang na te jagen.
De technische kloof achter die verschuiving is zichtbaar in recent onderzoek. Een paper van de Tsinghua Universiteit en Zhipu AI, met Tang Jie als corresponderend auteur, introduceert een model genaamd GLM-Omni. Het rapporteert 54% nauwkeurigheid bij beeldgeneratie maar slechts 14,57% bij tekstuele vraagbeantwoording — een splitsing die laat zien hoe één systeem sterk kan lijken op de ene ranglijst en fragiel op de andere. Gebruikers op sociale media koppelden de paper al snel aan een mogelijke release van GLM-5.5, hoewel de paper geen versietoewijzing bevestigt.
Zhipu is een van China’s bekendste AI-modelontwikkelaars, voortgekomen uit onderzoek aan Tsinghua en genoteerd in Hongkong. De GLM-Omni-resultaten suggereren dat de volgende concurrentieronde niet wordt gewonnen door één grafiek te domineren. Uniforme modellen die visie en taal samen verwerken, worden beoordeeld op of ze daadwerkelijk werk kunnen afronden: een document lezen, een bruikbare afbeelding genereren, een klantvraag beantwoorden zonder te hallucineren.
Dezelfde logica drijft de evaluatie-industrie zelf naar moeilijkere tests. Benchmarks op basis van meerkeuzevragen zijn goedkoop uit te voeren en makkelijk te omzeilen via overlap in trainingsdata; agentische taken waarbij een model moet plannen, tools moet gebruiken en van fouten moet herstellen, zijn duur en traag maar veel dichter bij waar bedrijven voor betalen. Het verzadigingspercentage van 36% is een waarschuwing dat de makkelijke metingen op zijn.
Voor wereldwijde kopers is het praktische gevolg een verandering in inkoop. In plaats van te vragen welk model bovenaan staat, draaien teams steeds vaker hun eigen kleine proeven op echte workflows en vergelijken ze de totale kosten, inclusief inferentiekosten en herhalingen. Chinese modelmakers, geconfronteerd met felle binnenlandse prijsconcurrentie, hebben een prikkel om resultaten op deze moeilijkere evaluaties te publiceren — maar ook om degenen eruit te pikken die ze winnen.
Het volgende signaal is of onafhankelijke evaluatoren het tempo kunnen bijhouden. Als verzadigde benchmarks de krantenkoppen blijven domineren terwijl praktijktests versnipperd blijven, zal de kloof tussen reputatie en levering groeien — en de bedrijven die hun eigen evaluatie-infrastructuur bouwen, zullen de betere weddenschappen sluiten.