Des chercheurs de Google découvrent un bug d'arrondi qui casse silencieusement l'entraînement des IA
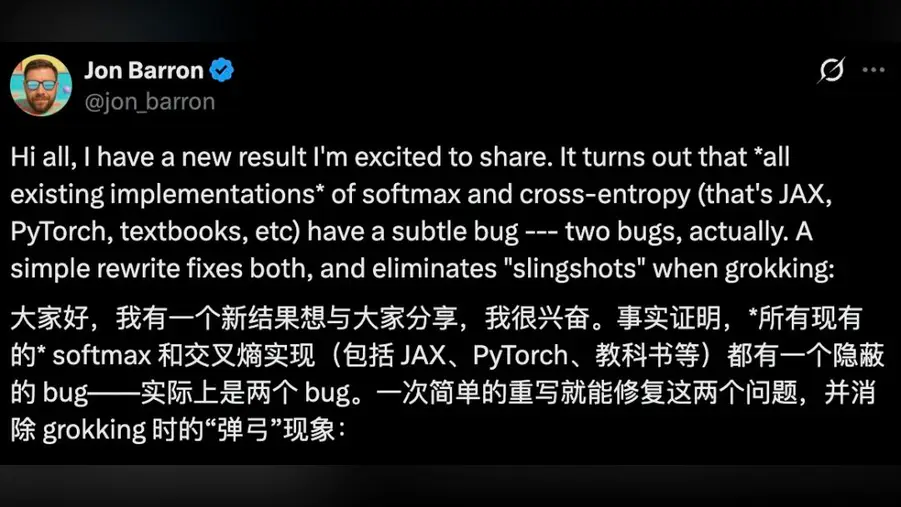
Un chercheur scientifique senior de Google DeepMind, Jon Barron, a signalé ce qui équivaut à une faute de frappe aux conséquences lourdes : dans les implémentations standard d’un algorithme d’entraînement largement utilisé, un nombre censé porter de l’information est discrètement arrondi à zéro. Le bug apparaît dans PyTorch et JAX, deux des frameworks logiciels les plus courants pour construire des modèles d’IA, ainsi que dans la formule imprimée dans les manuels.
L’effet n’est pas un plantage. C’est une fuite lente. Plus un modèle devient confiant dans une prédiction, plus le signal d’entraînement correct risque de disparaître dans cette étape d’arrondi. Privé de ce signal correctif, l’optimiseur qui ajuste les poids du modèle perd pied, et la courbe d’entraînement oscille au lieu de se stabiliser. En clair, la certitude du modèle peut effacer le retour d’information censé le corriger.
Ce qui dépasse le cadre d’un séminaire de recherche, c’est l’échelle. PyTorch et JAX sous-tendent la plupart des grands modèles de langage et générateurs d’images à usage commercial, des laboratoires américains aux développeurs chinois comme DeepSeek et l’équipe Qwen d’Alibaba, qui publient des modèles ouverts construits sur la même chaîne d’outils. Un défaut arithmétique subtil dans une bibliothèque partagée est l’une des rares choses capables de toucher simultanément des concurrents des deux côtés du Pacifique.
Selon le récit, le modèle Gemini de Google a pu identifier puis corriger le problème dans sa propre configuration d’entraînement, une première démonstration d’un modèle auditant le code qui construit les modèles. Ce détail risque d’attirer autant l’attention que le bug lui-même, car il suggère que la revue automatisée des pipelines d’entraînement pourrait devenir routine plutôt qu’une nouveauté.
Les questions pratiques sont peu glamour mais considérables. Quelle part de l’écart entre un entraînement bien sage et un entraînement agité revient à cette étape d’arrondi ? Certains modèles ont-ils été jugés difficiles à entraîner alors que la faute incombait à un paramètre par défaut de la bibliothèque ? Et combien de comparaisons de référence publiées, y compris celles servant à classer les modèles chinois et américains les uns par rapport aux autres, reposent sur des entraînements porteurs du défaut ?
Pour les équipes hors des grands laboratoires, la leçon immédiate est la vérification. Les paramètres par défaut des frameworks sont traités comme parole d’évangile par la plupart des ingénieurs, et les formules des manuels plus encore. Une seule constante mal spécifiée peut se propager à travers le fine-tuning, la distillation et l’évaluation sans que personne ne le remarque, car la sortie ressemble toujours à un modèle qui fonctionne, simplement moins stable.
Le point plus large concerne l’origine des progrès actuels en IA. Une grande partie du récent bond a été attribuée à des clusters plus grands et à plus de données. Cet épisode rappelle que la plomberie numérique sous-jacente, les parties que personne ne démontre, façonne encore ce que les modèles peuvent apprendre. Corriger une règle d’arrondi ne fera pas la une comme la sortie d’un nouveau modèle, mais cela pourrait changer les courbes d’entraînement pour tous ceux qui adopteront la correction.