Исследователи Google обнаружили ошибку округления, которая незаметно ломает обучение ИИ
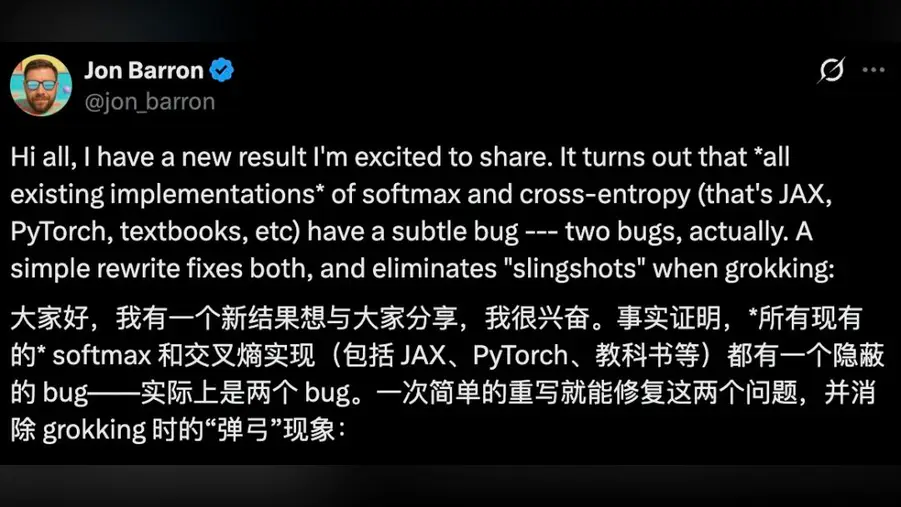
Старший научный сотрудник Google DeepMind Джон Бэррон указал на то, что по сути является опечаткой с последствиями: в стандартных реализациях широко используемого алгоритма обучения число, которое должно нести информацию, тихо округляется до нуля. Ошибка проявляется в PyTorch и JAX — двух самых распространённых программных фреймворках для построения моделей ИИ, — а также в формуле, напечатанной в учебниках.
Эффект не в сбое. Это медленная утечка. Чем увереннее модель становится в предсказании, тем вероятнее, что правильный сигнал обучения исчезает на этом шаге округления. Когда корректирующий сигнал пропадает, оптимизатор, настраивающий веса модели, теряет опору, и кривая обучения колеблется вместо того, чтобы стабилизироваться. Проще говоря, уверенность модели может стирать ту самую обратную связь, которая предназначена её исправлять.
Почему это важно за пределами научного семинара — масштаб. PyTorch и JAX лежат в основе большинства крупных языковых моделей и генераторов изображений коммерческого использования, от американских лабораторий до китайских разработчиков, таких как DeepSeek и команда Qwen от Alibaba, которые публикуют открытые модели, построенные на том же инструментарии. Тонкий арифметический изъян в общей библиотеке — одна из немногих вещей, способных одновременно затронуть конкурентов по обе стороны Тихого океана.
Согласно сообщению, модель Gemini от Google смогла выявить, а затем исправить проблему в собственной конфигурации обучения — ранняя демонстрация того, как модель проверяет код, который создаёт модели. Эта деталь, вероятно, привлечёт не меньше внимания, чем сама ошибка, поскольку предполагает, что автоматизированная проверка обучающих конвейеров может стать рутиной, а не диковинкой.
Практические вопросы неброские, но масштабные. Какая часть разрыва между хорошо управляемым обучением и дрожащим приходилась на этот шаг округления? Были ли некоторые модели списаны как сложные в обучении, тогда как вина лежала на настройке библиотеки по умолчанию? И сколько опубликованных сравнений бенчмарков, включая те, что используются для ранжирования китайских и американских моделей друг против друга, опираются на обучение, нёсшее этот изъян?
Для команд вне крупных лабораторий непосредственный урок — проверка. Настройки фреймворков по умолчанию большинство инженеров воспринимают как истину в последней инстанции, а формулы из учебников — тем более. Одна неверно заданная константа может распространиться через дообучение, дистилляцию и оценку, никем не замеченная, потому что результат всё ещё выглядит как работающая модель, просто менее стабильная.
Более широкий вопрос — откуда теперь берётся прогресс в ИИ. Значительная часть недавнего скачка приписывается более крупным кластерам и большему объёму данных. Этот эпизод напоминает, что числовая «сантехника» внизу, те части, которые никто не демонстрирует, по-прежнему определяет, чему могут научиться модели. Исправление правила округления не попадёт в заголовки так, как выпуск новой модели, но может изменить кривые обучения для всех, кто примет исправление.