Google-onderzoekers vinden afrondingsbug die AI-training stilletjes ondermijnt
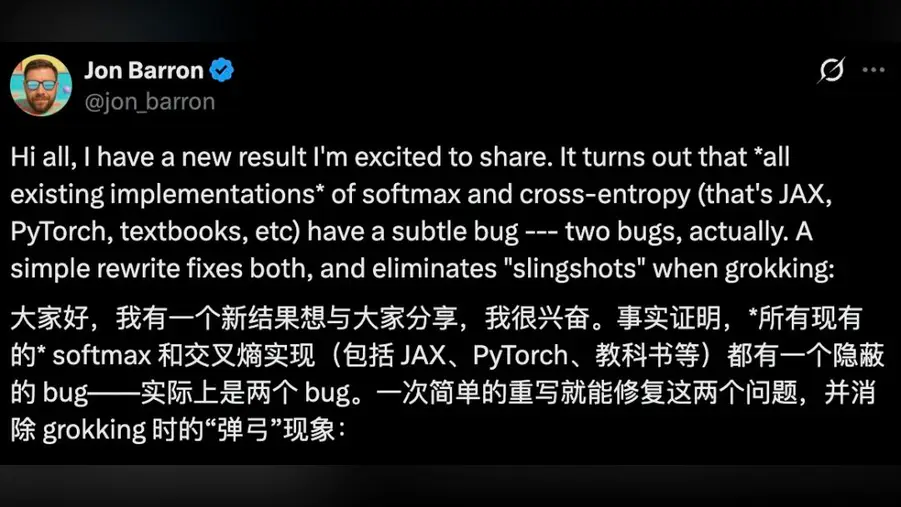
Een senior research scientist bij Google DeepMind, Jon Barron, heeft gewezen op wat neerkomt op een typo met gevolgen: in de standaardimplementaties van een veelgebruikt trainingsalgoritme wordt een getal dat informatie zou moeten dragen stilletjes naar nul afgerond. De bug duikt op in PyTorch en JAX, twee van de meest voorkomende softwareframeworks voor het bouwen van AI-modellen, en in de formule die in textbooks staat.
Het effect is geen crash. Het is een langzame lekkage. Hoe zekerder een model wordt over een voorspelling, hoe groter de kans dat het juiste trainingssignaal in die afrondingsstap verdwijnt. Zonder het corrigerende signaal verliest de optimizer die de gewichten van het model aanpast zijn houvast, en de trainingscurve slingert in plaats van te stabiliseren. Simpel gezegd: de zekerheid van het model kan precies de feedback wissen die bedoeld is om het te corrigeren.
Waarom dit verder reikt dan een onderzoeksseminar is schaal. PyTorch en JAX liggen ten grondslag aan de meeste grote taalmodellen en beeldgeneratoren in commercieel gebruik, van Amerikaanse labs tot Chinese ontwikkelaars zoals DeepSeek en het Qwen-team van Alibaba, die open modellen publiceren die op dezelfde toolchain zijn gebouwd. Een subtiele rekenfout in een gedeelde bibliotheek is een van de weinige dingen die concurrenten aan beide zijden van de Stille Oceaan tegelijk kan raken.
Volgens het verslag wist Google’s Gemini-model het probleem in zijn eigen trainingsopzet te identificeren en vervolgens te corrigeren, een vroege demonstratie van een model dat de code controleert waarmee modellen worden gebouwd. Dat detail zal waarschijnlijk net zoveel aandacht trekken als de bug zelf, omdat het suggereert dat geautomatiseerde controle van trainingspipelines routine kan worden in plaats van een noviteit.
De praktische vragen zijn weinig glamoureus maar groot. Hoeveel van de kloof tussen een nette training en een schokkerige kwam door deze afrondingsstap? Werden sommige modellen afgeschreven als moeilijk te trainen terwijl de fout in een bibliotheekdefault lag? En hoeveel gepubliceerde benchmarkvergelijkingen, inclusief die waarmee Chinese en Amerikaanse modellen tegen elkaar worden gerangschikt, berusten op trainingen die de fout bevatten?
Voor teams buiten de grote labs is de onmiddellijke les verificatie. Frameworkdefaults worden door de meeste ingenieurs als waarheid beschouwd, en textbookformules nog meer. Een enkele verkeerd gespecificeerde constante kan zich verspreiden via fine-tuning, distillatie en evaluatie zonder dat iemand het merkt, omdat de output er nog steeds uitziet als een model dat werkt, alleen een minder stabiel model.
Het bredere punt gaat over waar vooruitgang in AI nu vandaan komt. Een groot deel van de recente sprong is toegeschreven aan grotere clusters en meer data. Deze episode herinnert eraan dat de numerieke leidingen eronder, de delen die niemand demonstreert, nog steeds bepalen wat modellen kunnen leren. Een afrondingsregel repareren haalt geen krantenkoppen zoals een nieuwe modelrelease, maar kan de trainingscurves veranderen voor iedereen die de correctie overneemt.