Ricercatori Google scoprono un bug di arrotondamento che compromette silenziosamente l'addestramento dell'IA
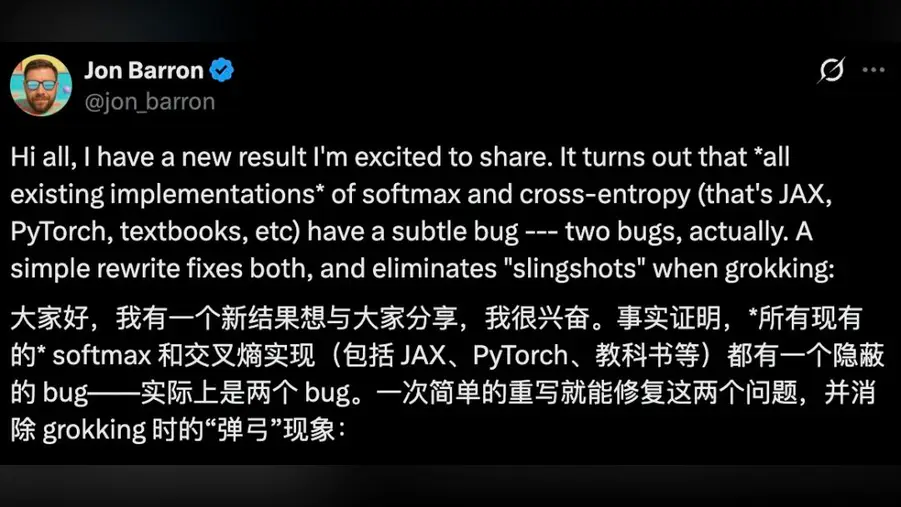
Un ricercatore senior di Google DeepMind, Jon Barron, ha segnalato quello che equivale a un refuso con conseguenze: nelle implementazioni standard di un algoritmo di addestramento ampiamente utilizzato, un numero che dovrebbe trasportare informazione viene silenziosamente arrotondato a zero. Il bug compare in PyTorch e JAX, due dei framework software più comuni per costruire modelli di IA, e nella formula stampata sui libri di testo.
L’effetto non è un crash. È una perdita lenta. Più un modello diventa sicuro di una previsione, più è probabile che il segnale di addestramento corretto svanisca in quell’arrotondamento. Con il segnale correttivo sparito, l’ottimizzatore che regola i pesi del modello perde l’equilibrio, e la curva di addestramento oscilla invece di stabilizzarsi. In parole semplici, la certezza del modello può cancellare proprio il feedback destinato a correggerlo.
Ciò che rende la cosa rilevante oltre il seminario di ricerca è la scala. PyTorch e JAX sono alla base della maggior parte dei grandi modelli linguistici e dei generatori di immagini in uso commerciale, dai laboratori americani agli sviluppatori cinesi come DeepSeek e il team Qwen di Alibaba, che pubblicano modelli aperti costruiti sulla stessa toolchain. Un sottile difetto aritmetico in una libreria condivisa è una delle poche cose che possono toccare contemporaneamente i concorrenti su entrambe le sponde del Pacifico.
Secondo il resoconto, il modello Gemini di Google è riuscito a identificare e poi correggere il problema nella propria configurazione di addestramento, una prima dimostrazione di un modello che verifica il codice che costruisce i modelli. Quel dettaglio probabilmente attirerà tanta attenzione quanto il bug stesso, perché suggerisce che la revisione automatizzata delle pipeline di addestramento potrebbe diventare routine anziché una novità.
Le domande pratiche sono poco glamour ma importanti. Quanta parte del divario tra un addestramento ben comportato e uno tremolante era dovuta a questo arrotondamento? Alcuni modelli sono stati liquidati come difficili da addestrare quando il difetto era in un default della libreria? E quante comparazioni di benchmark pubblicate, comprese quelle usate per classificare modelli cinesi e americani gli uni contro gli altri, si basano su addestramenti che portavano il difetto?
Per i team fuori dai grandi laboratori, la lezione immediata è la verifica. I default dei framework sono trattati come verità assoluta dalla maggior parte degli ingegneri, e le formule dei libri di testo ancora di più. Una singola costante mal specificata può propagarsi attraverso fine-tuning, distillazione e valutazione senza che nessuno se ne accorga, perché l’output sembra comunque un modello che funziona, solo meno stabile.
Il punto più ampio riguarda da dove viene ora il progresso nell’IA. Gran parte del recente balzo è stata attribuita a cluster più grandi e più dati. Questo episodio ricorda che l’idraulica numerica sottostante, le parti che nessuno mostra in demo, continua a plasmare ciò che i modelli possono imparare. Correggere una regola di arrotondamento non farà notizia come il lancio di un nuovo modello, ma potrebbe cambiare le curve di addestramento per tutti coloro che adotteranno la correzione.