Google-Forscher finden Rundungsfehler, der KI-Training stillschweigend bricht
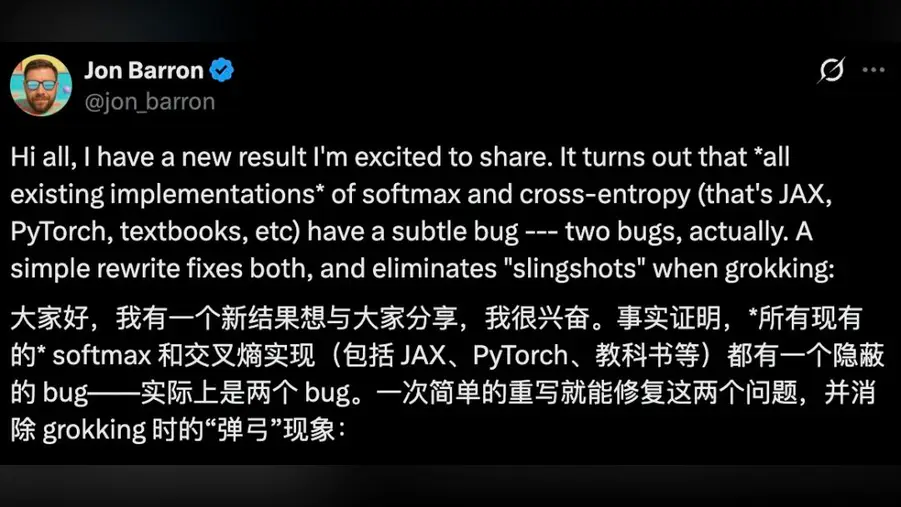
Ein leitender Forschungswissenschaftler bei Google DeepMind, Jon Barron, hat auf das hingewiesen, was einem Tippfehler mit Folgen gleichkommt: In den Standardimplementierungen eines weit verbreiteten Trainingsalgorithmus wird eine Zahl, die Informationen tragen sollte, stillschweigend auf null abgerundet. Der Fehler zeigt sich in PyTorch und JAX, zwei der gängigsten Software-Frameworks für den Bau von KI-Modellen, und in der in Lehrbüchern abgedruckten Formel.
Die Wirkung ist kein Absturz. Sie ist ein langsames Leck. Je sicherer sich ein Modell einer Vorhersage ist, desto wahrscheinlicher verschwindet das korrekte Trainingssignal in diesem Rundungsschritt. Ohne das Korrektursignal verliert der Optimierer, der die Gewichte des Modells anpasst, den Halt, und die Trainingskurve schwingt, statt sich zu beruhigen. Einfach gesagt: Die Gewissheit des Modells kann genau die Rückmeldung auslöschen, die es korrigieren soll.
Warum das über ein Forschungsseminar hinausgeht, ist der Maßstab. PyTorch und JAX bilden die Grundlage für die meisten großen Sprachmodelle und Bildgeneratoren im kommerziellen Einsatz, von US-Laboren bis zu chinesischen Entwicklern wie DeepSeek und dem Qwen-Team von Alibaba, die offene Modelle auf derselben Toolchain veröffentlichen. Ein subtiler Arithmetikfehler in einer gemeinsam genutzten Bibliothek gehört zu den wenigen Dingen, die Wettbewerber auf beiden Seiten des Pazifiks gleichzeitig treffen können.
Dem Bericht zufolge konnte Googles Modell Gemini das Problem in seiner eigenen Trainingsumgebung identifizieren und dann beheben – eine frühe Demonstration eines Modells, das den Code prüft, der Modelle baut. Dieses Detail dürfte ebenso viel Aufmerksamkeit auf sich ziehen wie der Fehler selbst, deutet es doch darauf hin, dass die automatisierte Überprüfung von Trainingspipelines Routine werden könnte statt einer Neuheit.
Die praktischen Fragen sind wenig glamourös, aber groß. Wie viel der Lücke zwischen einem braven und einem zittrigen Trainingslauf ging auf diesen Rundungsschritt zurück? Wurden manche Modelle als schwer trainierbar abgeschrieben, obwohl der Fehler in einer Bibliotheksvoreinstellung lag? Und wie viele veröffentlichte Benchmark-Vergleiche, auch jene, mit denen chinesische und amerikanische Modelle gegeneinander eingestuft werden, beruhen auf Trainingsläufen, die den Fehler trugen?
Für Teams außerhalb der großen Labore lautet die unmittelbare Lehre: überprüfen. Framework-Voreinstellungen werden von den meisten Ingenieuren als gesicherte Wahrheit behandelt, Lehrbuchformeln erst recht. Eine einzige falsch spezifizierte Konstante kann sich durch Feintuning, Destillation und Evaluierung fortpflanzen, ohne dass es jemand bemerkt, weil die Ausgabe immer noch wie ein funktionierendes Modell aussieht – nur wie ein weniger stabiles.
Der größere Punkt betrifft die Frage, woher der Fortschritt in der KI derzeit kommt. Ein Großteil des jüngsten Sprungs wurde größeren Clustern und mehr Daten zugeschrieben. Diese Episode erinnert daran, dass die numerische Verrohrung darunter, die Teile, die niemand vorführt, weiterhin prägt, was Modelle lernen können. Eine Rundungsregel zu korrigieren wird keine Schlagzeilen machen wie die Veröffentlichung eines neuen Modells, aber es könnte die Trainingskurven für alle verändern, die die Korrektur übernehmen.