Pesquisadores do Google encontram bug de arredondamento que quebra silenciosamente o treinamento de IA
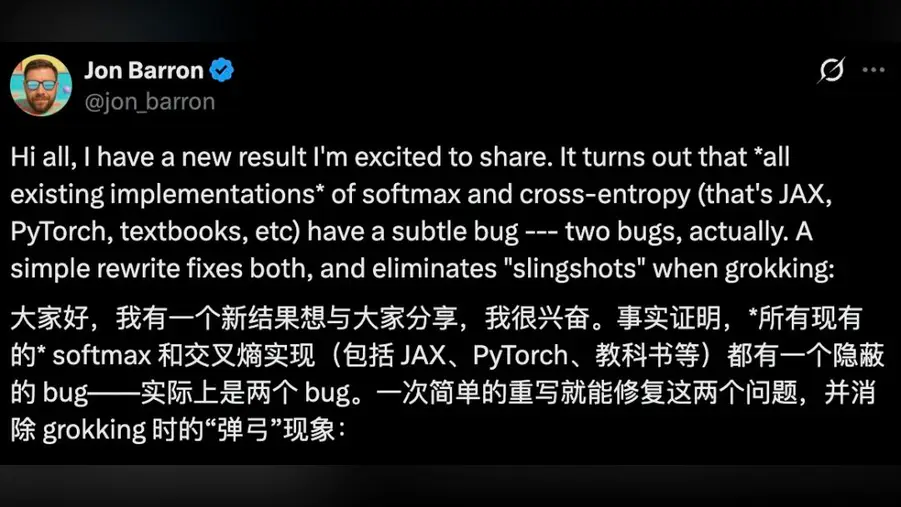
Um cientista pesquisador sênior do Google DeepMind, Jon Barron, sinalizou o que equivale a um erro de digitação com consequências: nas implementações padrão de um algoritmo de treinamento amplamente usado, um número que deveria carregar informação está sendo silenciosamente arredondado para zero. O bug aparece no PyTorch e no JAX, dois dos frameworks de software mais comuns para construir modelos de IA, e na fórmula impressa nos livros-texto.
O efeito não é uma falha catastrófica. É um vazamento lento. Quanto mais confiante um modelo fica em uma previsão, mais provável é que o sinal de treinamento correto desapareça nessa etapa de arredondamento. Sem o sinal corretivo, o otimizador que ajusta os pesos do modelo perde o equilíbrio, e a curva de treinamento oscila em vez de se estabilizar. Em termos simples, a certeza do modelo pode apagar justamente o feedback destinado a corrigi-lo.
O que faz isso transcender um seminário de pesquisa é a escala. PyTorch e JAX sustentam a maioria dos grandes modelos de linguagem e geradores de imagens em uso comercial, de laboratórios americanos a desenvolvedores chineses como a DeepSeek e a equipe Qwen, da Alibaba, que publicam modelos abertos construídos sobre a mesma cadeia de ferramentas. Uma falha aritmética sutil em uma biblioteca compartilhada é uma das poucas coisas capazes de atingir concorrentes dos dois lados do Pacífico ao mesmo tempo.
Segundo o relato, o modelo Gemini, do Google, conseguiu identificar e depois corrigir o problema em sua própria configuração de treinamento, uma demonstração precoce de um modelo auditando o código que constrói modelos. Esse detalhe provavelmente atrairá tanta atenção quanto o próprio bug, porque sugere que a revisão automatizada de pipelines de treinamento pode se tornar rotina em vez de novidade.
As perguntas práticas são pouco glamourosas, mas enormes. Quanto da diferença entre um treinamento bem comportado e um instável se deveu a essa etapa de arredondamento? Alguns modelos foram descartados como difíceis de treinar quando a culpa estava em um padrão da biblioteca? E quantas comparações de benchmark publicadas, incluindo as usadas para classificar modelos chineses e americanos entre si, se baseiam em treinamentos que carregavam a falha?
Para equipes fora dos grandes laboratórios, a lição imediata é a verificação. Padrões de frameworks são tratados como verdade absoluta pela maioria dos engenheiros, e fórmulas de livros-texto mais ainda. Uma única constante mal especificada pode se propagar pelo ajuste fino, pela destilação e pela avaliação sem que ninguém perceba, porque a saída ainda parece um modelo que funciona, apenas menos estável.
O ponto mais amplo é de onde vem agora o progresso em IA. Grande parte do salto recente foi atribuída a clusters maiores e mais dados. Este episódio lembra que o encanamento numérico por baixo, as partes que ninguém demonstra, ainda molda o que os modelos podem aprender. Corrigir uma regra de arredondamento não vai gerar manchetes como o lançamento de um novo modelo, mas pode mudar as curvas de treinamento para todos que adotarem a correção.