Investigadores de Google hallan un error de redondeo que rompe silenciosamente el entrenamiento de la IA
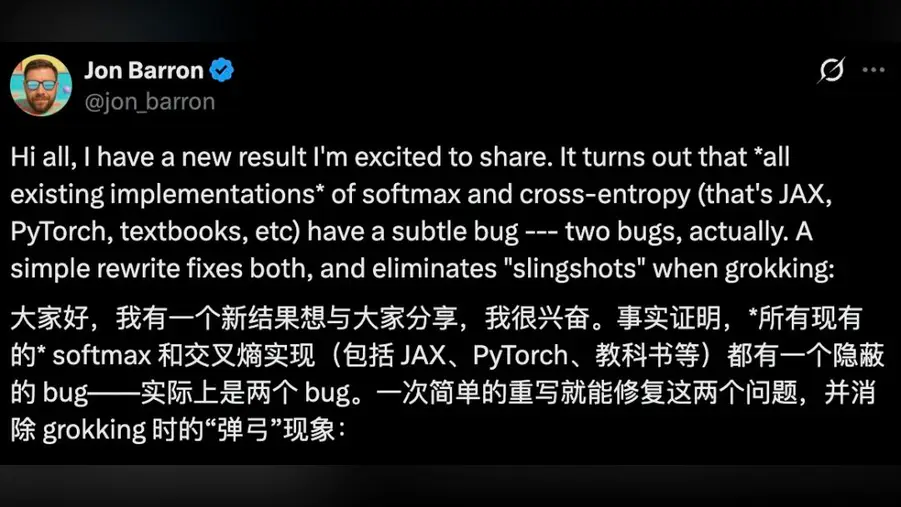
Un científico investigador sénior de Google DeepMind, Jon Barron, ha señalado lo que equivale a una errata con consecuencias: en las implementaciones estándar de un algoritmo de entrenamiento ampliamente utilizado, un número que debería transportar información se redondea silenciosamente a cero. El error aparece en PyTorch y JAX, dos de los marcos de software más comunes para construir modelos de IA, y en la fórmula impresa en los libros de texto.
El efecto no es un fallo catastrófico. Es una fuga lenta. Cuanto más confiado se vuelve un modelo en una predicción, más probable es que la señal de entrenamiento correcta desaparezca en ese paso de redondeo. Sin la señal correctiva, el optimizador que ajusta los pesos del modelo pierde el equilibrio y la curva de entrenamiento oscila en lugar de estabilizarse. En términos sencillos, la certeza del modelo puede borrar la propia retroalimentación destinada a corregirlo.
Lo que hace que esto trascienda un seminario de investigación es la escala. PyTorch y JAX sustentan la mayoría de los grandes modelos de lenguaje y generadores de imágenes de uso comercial, desde laboratorios estadounidenses hasta desarrolladores chinos como DeepSeek y el equipo Qwen de Alibaba, que publican modelos abiertos construidos sobre la misma cadena de herramientas. Un fallo aritmético sutil en una biblioteca compartida es una de las pocas cosas que pueden afectar a competidores a ambos lados del Pacífico a la vez.
Según el relato, el modelo Gemini de Google pudo identificar y luego corregir el problema en su propia configuración de entrenamiento, una demostración temprana de un modelo auditando el código que construye modelos. Es probable que ese detalle atraiga tanta atención como el propio error, porque sugiere que la revisión automatizada de los flujos de entrenamiento podría volverse rutinaria en lugar de una novedad.
Las preguntas prácticas son poco glamurosas pero enormes. ¿Cuánto de la diferencia entre un entrenamiento bien comportado y uno inestable se debió a este paso de redondeo? ¿Se descartaron algunos modelos por considerarlos difíciles de entrenar cuando la culpa estaba en un valor predeterminado de la biblioteca? ¿Y cuántas comparaciones de referencia publicadas, incluidas las usadas para clasificar modelos chinos y estadounidenses entre sí, se basan en entrenamientos que arrastraban el fallo?
Para los equipos fuera de los grandes laboratorios, la lección inmediata es la verificación. Los valores predeterminados de los marcos se tratan como verdad absoluta por la mayoría de los ingenieros, y las fórmulas de los libros de texto aún más. Una sola constante mal especificada puede propagarse a través del ajuste fino, la destilación y la evaluación sin que nadie lo note, porque la salida sigue pareciendo un modelo que funciona, solo que menos estable.
El punto más amplio es de dónde proviene ahora el progreso en IA. Gran parte del salto reciente se ha atribuido a clústeres más grandes y más datos. Este episodio recuerda que la fontanería numérica subyacente, las partes que nadie demuestra, sigue moldeando lo que los modelos pueden aprender. Corregir una regla de redondeo no acaparará titulares como el lanzamiento de un nuevo modelo, pero puede cambiar las curvas de entrenamiento para todos los que adopten la corrección.