Una correzione dello 0,016% dei pesi ha posto fine al loop da 30.000 token di Qwen
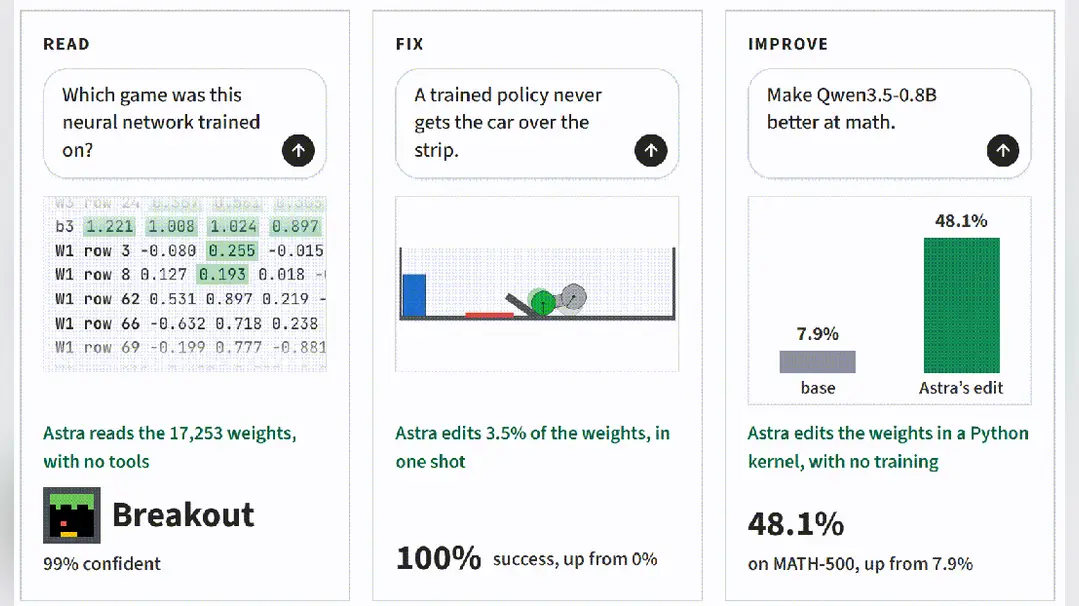
Un modello di ragionamento ha continuato a lavorare su un problema matematico oltre i 30.000 token, ripetendo gli stessi passaggi senza mai fornire una risposta. Il tipo di errore è familiare a chiunque abbia visto un grande modello linguistico girare a vuoto: più ragionamento, nessun progresso. La soluzione descritta in un articolo tecnico cinese ampiamente diffuso non è stata una nuova sessione di addestramento, ma una modifica chirurgica a una frazione minuscola dei parametri del modello: circa lo 0,016% dei pesi, secondo il resoconto.
Il meccanismo è la parte interessante. Lo stesso modello è stato usato sia per leggere i propri pesi sia per riscriverli. Nella pratica convenzionale, migliorare un modello significa discesa del gradiente: fornirgli esempi, calcolare la perdita e ritoccare milioni o miliardi di parametri nell’arco di molte ore. Qui il modello ispeziona il proprio stato interno, diagnostica quello che definisce un loop e applica una correzione mirata. L’articolo lo presenta come un canale rapido per l’IA che migliora l’IA, aggirando del tutto la discesa del gradiente.
Qwen è la famiglia di modelli sviluppata da Alibaba, una delle maggiori aziende tecnologiche cinesi, e le sue versioni a pesi aperti l’hanno resa una base comune per ricercatori e appassionati in tutto il mondo. Il problema del loop non è esclusivo di Qwen. I modelli di ragionamento con lunghe catene di pensiero di diversi laboratori hanno mostrato una tendenza a pensare troppo, consumando token in passaggi ridondanti e talvolta non riuscendo a fermarsi. Il consumo di token è anche un costo: ogni migliaio di token in più viene fatturato come calcolo.
Se il risultato regge, le implicazioni vanno in due direzioni. Da un lato, la manutenzione del modello diventa più economica e precisa: un modello potrebbe correggere da solo le proprie modalità di errore ricorrenti senza un ciclo completo di riaddestramento. Dall’altro, il confine tra mantenere un modello e ampliarne le capacità inizia a sfumare. Un sistema in grado di leggere e riscrivere i propri pesi è un sistema che può, in linea di principio, cambiare ciò che è. L’articolo lo dice esplicitamente: la linea tra manutenzione del modello e scalabilità delle capacità diventa sfumata.
L’affermazione arriva con delle avvertenze. Un singolo caso segnalato di interruzione di un loop non è prova di un metodo generale. Se la modifica sia generalizzabile, cioè se il modello ragioni ancora correttamente su altri problemi dopo il cambiamento dei pesi, è la domanda a cui qualsiasi risultato del genere deve rispondere. La cifra dello 0,016% colpisce proprio perché è piccola, ma piccole modifiche possono avere effetti grandi e imprevedibili altrove in una rete.
Il contesto più ampio è un periodo intenso per la ricerca cinese sull’IA. Nelle ultime settimane, i team hanno pubblicato lavori su agenti che si autoistruiscono in loop, su motori di inferenza open source e su modelli addestrati interamente su chip nazionali. L’automodifica si colloca all’estremità più speculativa di questo spettro, ma sta attirando attenzione perché affronta un vero grattacapo operativo: modelli che sprecano token senza andare da nessuna parte.
Per i lettori globali, la lezione pratica è che la frontiera del miglioramento dei modelli si sta ampliando oltre le sessioni di addestramento più grandi. La modifica a livello di pesi, l’autodiagnosi e l’interruzione dei loop stanno diventando argomenti di ricerca a sé stanti. Il prossimo segnale da osservare è la replica: se gruppi indipendenti riescano a riprodurre la correzione su altri modelli e a dimostrare che la rete modificata resta stabile tra i compiti, non solo sul problema che ha innescato la modifica.