Un ajuste del 0,016 % de los pesos puso fin al bucle de 30.000 tokens de Qwen
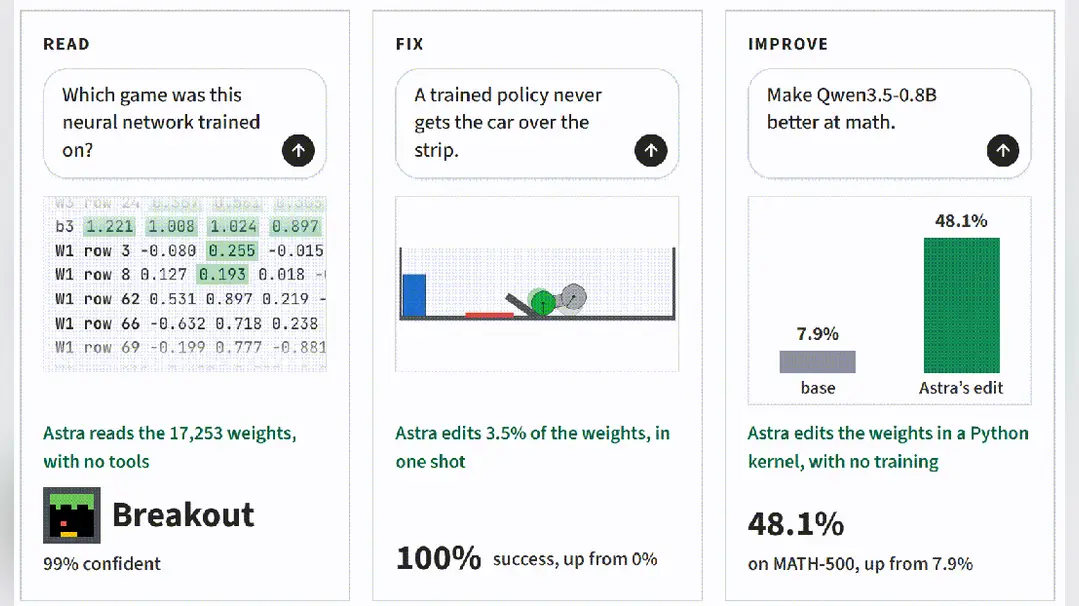
Un modelo de razonamiento siguió trabajando en un problema matemático más allá de los 30.000 tokens, repitiendo los mismos pasos sin llegar nunca a una respuesta. El modo de fallo resulta familiar para cualquiera que haya visto a un gran modelo de lenguaje entrar en espiral: más pensamiento, ningún avance. La solución descrita en un artículo técnico chino ampliamente compartido no fue una nueva ronda de entrenamiento, sino una edición quirúrgica de una fracción mínima de los parámetros del modelo: alrededor del 0,016 % de los pesos, según el relato.
El mecanismo es lo interesante. El mismo modelo se utilizó tanto para leer sus propios pesos como para reescribirlos. En la práctica convencional, mejorar un modelo significa descenso de gradiente: darle ejemplos, calcular la pérdida y ajustar millones o miles de millones de parámetros durante muchas horas. Aquí, el modelo inspecciona su estado interno, diagnostica lo que llama un bucle y aplica una corrección específica. El artículo lo presenta como una vía rápida para que la IA se mejore a sí misma que se salta por completo el descenso de gradiente.
Qwen es la familia de modelos desarrollada por Alibaba, una de las mayores tecnológicas de China, y sus lanzamientos de pesos abiertos la han convertido en una base habitual para investigadores y aficionados de todo el mundo. El problema del bucle no es exclusivo de Qwen. Los modelos de razonamiento con cadenas de pensamiento largas de varios laboratorios han mostrado una tendencia a pensar en exceso, gastando tokens en pasos redundantes y a veces sin lograr detenerse. El consumo de tokens también es un coste: cada millar adicional se factura como cómputo.
Si el resultado se sostiene, las implicaciones van en dos direcciones. Por un lado, el mantenimiento de los modelos se vuelve más barato y preciso: un modelo podría parchear sus propios modos de fallo recurrentes sin un ciclo completo de reentrenamiento. Por otro, la frontera entre mantener un modelo y ampliar sus capacidades empieza a difuminarse. Un sistema capaz de leer y reescribir sus propios pesos es un sistema que, en principio, puede cambiar lo que es. El artículo lo dice: la línea entre el mantenimiento del modelo y la ampliación de capacidades se vuelve borrosa.
La afirmación llega con salvedades. Un único caso reportado de ruptura de un bucle no es prueba de un método general. Si la edición se generaliza —si el modelo sigue razonando correctamente en otros problemas tras el cambio de pesos— es la pregunta que debe responder cualquier resultado de este tipo. La cifra del 0,016 % llama la atención precisamente por ser pequeña, pero las ediciones pequeñas pueden tener efectos grandes e impredecibles en otras partes de una red.
El contexto más amplio es un periodo de gran actividad para la investigación china en IA. En las últimas semanas, equipos han publicado trabajos sobre agentes que se enseñan a sí mismos en bucles, sobre motores de inferencia de código abierto y sobre modelos entrenados íntegramente en chips nacionales. La automodificación se sitúa en el extremo más especulativo de ese espectro, pero atrae atención porque ataca un dolor de cabeza operativo real: modelos que malgastan tokens sin ir a ninguna parte.
Para el lector global, la conclusión práctica es que la frontera de la mejora de modelos se está ampliando más allá de los grandes entrenamientos. La edición a nivel de pesos, el autodiagnóstico y la ruptura de bucles se están convirtiendo en temas de investigación por derecho propio. La próxima señal que observar es la replicación: si grupos independientes pueden reproducir la corrección en otros modelos y demostrar que la red editada sigue siendo estable en distintas tareas, no solo en el problema que motivó la edición.