Een gewichtscorrectie van 0,016% verhielp Qwens lus van 30.000 tokens
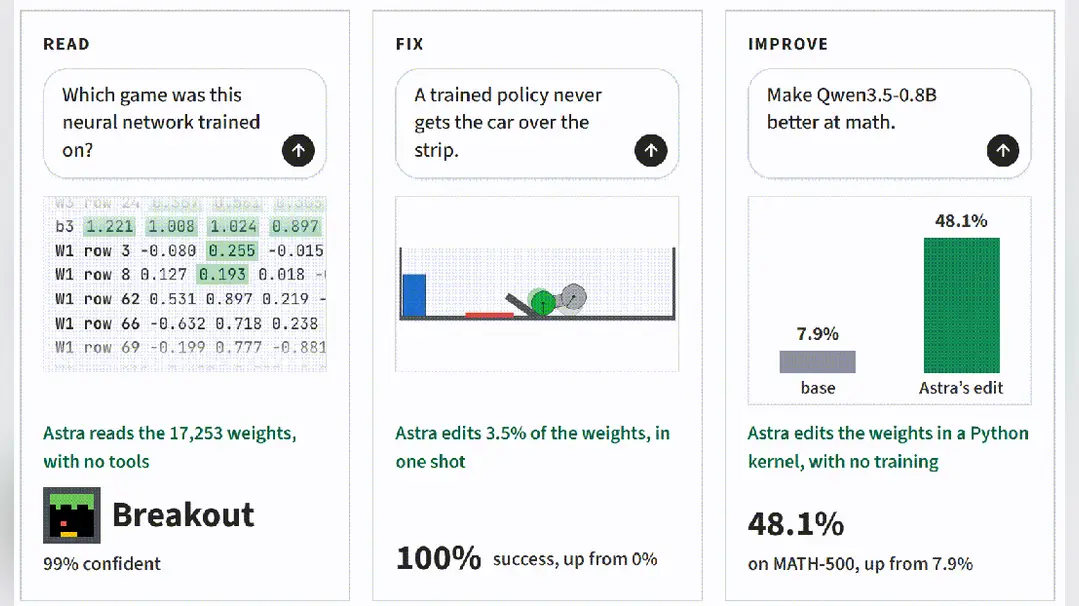
Een redeneermodel bleef aan een wiskundeprobleem werken tot voorbij 30.000 tokens, herhaalde dezelfde stappen en kwam nooit met een antwoord. De faalmodus is bekend voor iedereen die een groot taalmodel heeft zien rondtollen: meer denken, geen vooruitgang. De oplossing die in een veel gedeelde Chinese technische beschrijving wordt geschetst, was geen nieuwe trainingsrun maar een chirurgische ingreep in een minuscule fractie van de parameters van het model: ongeveer 0,016% van de gewichten, volgens het verslag.
Het mechanisme is het interessante deel. Hetzelfde model werd zowel gebruikt om zijn eigen gewichten te lezen als om ze te herschrijven. In de gangbare praktijk betekent een model verbeteren gradiëntafdaling: het voorbeelden voeren, de loss berekenen en miljoenen of miljarden parameters gedurende vele uren bijstellen. Hier inspecteert het model zijn interne toestand, diagnosticeert wat het een lus noemt en past een gerichte correctie toe. De beschrijving presenteert dit als een sluiproute voor AI die AI verbetert, waarbij gradiëntafdaling volledig wordt omzeild.
Qwen is de modelfamilie die door Alibaba is ontwikkeld, een van China’s grootste technologiebedrijven, en de open-weight releases hebben het een gangbare basis gemaakt voor onderzoekers en hobbyisten wereldwijd. Het lusprobleem is niet uniek voor Qwen. Redeneermodellen met lange chain-of-thought van verschillende labs hebben de neiging getoond te veel na te denken, tokens te verspillen aan overbodige stappen en soms niet te stoppen. Tokenverbruik is ook een kostenpost: elke extra duizend tokens wordt als rekenkracht gefactureerd.
Als het resultaat standhoudt, snijdt de betekenis twee kanten op. Enerzijds wordt modelonderhoud goedkoper en preciezer: een model zou zijn eigen terugkerende faalmodi kunnen patchen zonder een volledige hertraining. Anderzijds begint de grens tussen het onderhouden van een model en het vergroten van zijn capaciteiten te vervagen. Een systeem dat zijn eigen gewichten kan lezen en herschrijven, is een systeem dat in principe kan veranderen wat het is. De beschrijving zegt dat ook: de lijn tussen modelonderhoud en capaciteitsschaalvergroting wordt vaag.
De bewering komt met kanttekeningen. Een enkel gemeld geval van het doorbreken van één lus is geen bewijs van een algemene methode. Of de ingreep generaliseert, of het model na de gewichtswijziging nog steeds correct redeneert bij andere problemen, is de vraag die elk dergelijk resultaat moet beantwoorden. Het cijfer van 0,016% valt juist op omdat het klein is, maar kleine ingrepen kunnen elders in een netwerk grote, onvoorspelbare effecten hebben.
De bredere context is een drukke periode voor Chinees AI-onderzoek. De afgelopen weken hebben teams werk gepubliceerd over agents die zichzelf in lussen leren, over open-source inference-engines en over modellen die volledig op binnenlandse chips zijn getraind. Zelfmodificatie zit aan het meer speculatieve uiteinde van dat spectrum, maar trekt aandacht omdat het een echt operationeel hoofdpijndossier aanpakt: modellen die tokens verspillen zonder ergens te komen.
Voor wereldwijde lezers is de praktische les dat de grens van modelverbetering zich verbreedt voorbij grotere trainingsruns. Gewichtsniveau-bewerking, zelfdiagnose en lusdoorbreking worden zelfstandige onderzoeksthema’s. Het volgende signaal om op te letten is replicatie: of onafhankelijke groepen de oplossing op andere modellen kunnen reproduceren en kunnen aantonen dat het bewerkte netwerk stabiel blijft over taken, niet alleen bij het probleem dat de ingreep uitlokte.