Um ajuste de 0,016% nos pesos encerrou o loop de 30.000 tokens do Qwen
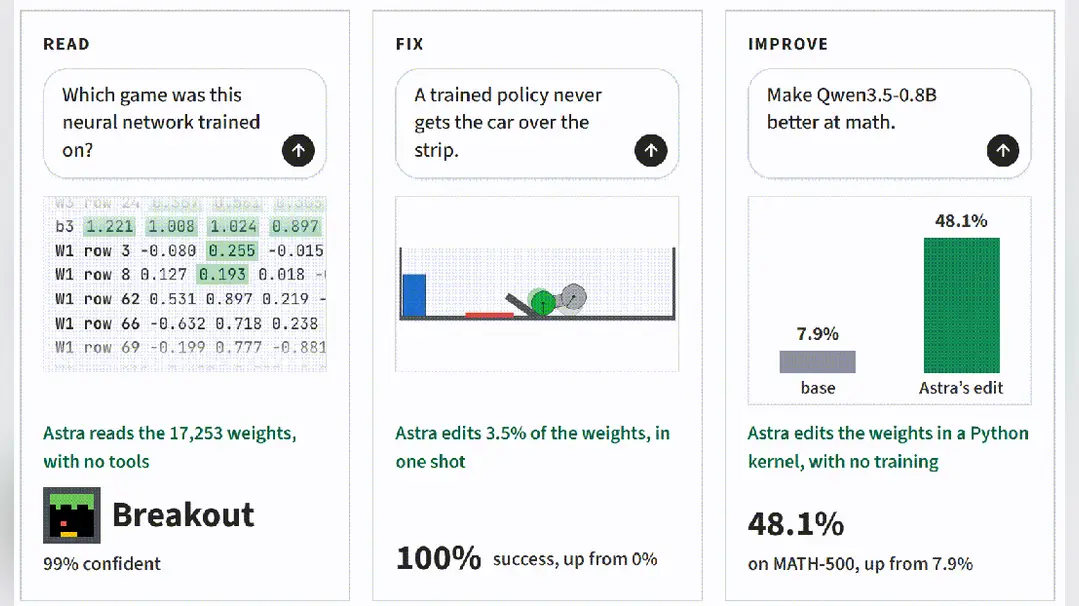
Um modelo de raciocínio continuou trabalhando em um problema de matemática além dos 30.000 tokens, repetindo os mesmos passos e nunca entregando uma resposta. O modo de falha é familiar para quem já viu um grande modelo de linguagem entrar em espiral: mais pensamento, nenhum progresso. A correção descrita em um artigo técnico chinês amplamente compartilhado não foi um novo ciclo de treinamento, mas uma edição cirúrgica em uma fração mínima dos parâmetros do modelo — cerca de 0,016% dos pesos, segundo o relato.
O mecanismo é a parte interessante. O mesmo modelo foi usado tanto para ler os próprios pesos quanto para reescrevê-los. Na prática convencional, melhorar um modelo significa descida de gradiente: fornecer exemplos, calcular a perda e ajustar milhões ou bilhões de parâmetros ao longo de muitas horas. Aqui, o modelo inspeciona seu estado interno, diagnostica o que chama de loop e aplica uma correção direcionada. O artigo apresenta isso como um atalho para a IA melhorar a própria IA, que dispensa por completo a descida de gradiente.
O Qwen é a família de modelos desenvolvida pela Alibaba, uma das maiores empresas de tecnologia da China, e seus lançamentos de pesos abertos a tornaram uma base comum para pesquisadores e entusiastas no mundo todo. O problema do loop não é exclusivo do Qwen. Modelos de raciocínio com cadeias de pensamento longas de vários laboratórios têm mostrado tendência a pensar demais, gastando tokens em passos redundantes e às vezes sem conseguir parar. O consumo de tokens também é um custo: cada milhar extra é cobrado como processamento.
Se o resultado se sustentar, as implicações vão em duas direções. De um lado, a manutenção do modelo fica mais barata e precisa — um modelo poderia corrigir seus próprios modos de falha recorrentes sem um ciclo completo de retreinamento. Do outro, a fronteira entre manter um modelo e ampliar suas capacidades começa a se confundir. Um sistema capaz de ler e reescrever os próprios pesos é um sistema que pode, em princípio, mudar o que é. O artigo diz isso: a linha entre manutenção do modelo e ampliação de capacidades fica nebulosa.
A alegação vem com ressalvas. Um único caso relatado de quebra de um loop não é prova de um método geral. Se a edição se generaliza — se o modelo continua raciocinando corretamente em outros problemas após a mudança nos pesos — é a pergunta que qualquer resultado desse tipo precisa responder. O número de 0,016% chama atenção justamente por ser pequeno, mas edições pequenas podem ter efeitos grandes e imprevisíveis em outras partes de uma rede.
O contexto mais amplo é um período movimentado para a pesquisa chinesa em IA. Nas últimas semanas, equipes publicaram trabalhos sobre agentes que se ensinam sozinhos em loops, sobre motores de inferência de código aberto e sobre modelos treinados inteiramente em chips nacionais. A automodificação fica na ponta mais especulativa desse espectro, mas atrai atenção porque ataca uma dor de cabeça operacional real: modelos que desperdiçam tokens sem sair do lugar.
Para o leitor global, a conclusão prática é que a fronteira da melhoria de modelos está se ampliando para além dos grandes treinamentos. A edição no nível dos pesos, o autodiagnóstico e a quebra de loops estão se tornando temas de pesquisa por direito próprio. O próximo sinal a observar é a replicação: se grupos independentes conseguem reproduzir a correção em outros modelos e mostrar que a rede editada permanece estável em diferentes tarefas, não apenas no problema que motivou a edição.