Un ajustement de 0,016 % des poids met fin à la boucle de 30 000 tokens de Qwen
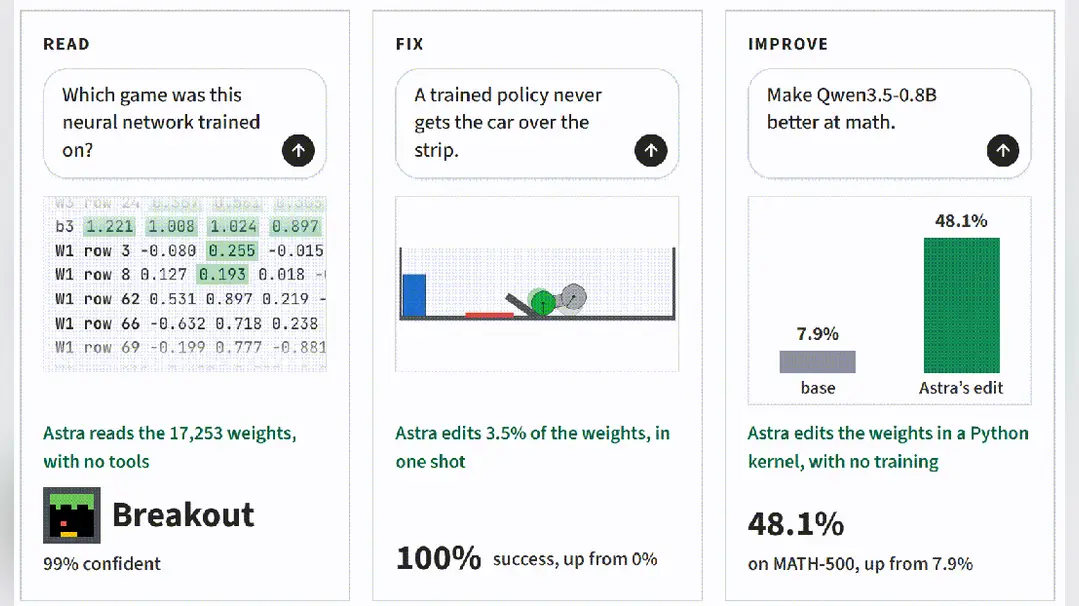
Un modèle de raisonnement a continué à travailler sur un problème de mathématiques au-delà de 30 000 tokens, répétant les mêmes étapes sans jamais livrer de réponse. Ce mode de défaillance est familier à quiconque a vu un grand modèle de langage partir en spirale : plus de réflexion, aucun progrès. Le correctif décrit dans une note technique chinoise largement partagée n’était pas un nouvel entraînement, mais une édition chirurgicale d’une infime fraction des paramètres du modèle — environ 0,016 % des poids, selon le récit.
Le mécanisme est la partie intéressante. Le même modèle a servi à la fois à lire ses propres poids et à les réécrire. Dans la pratique classique, améliorer un modèle passe par la descente de gradient : lui fournir des exemples, calculer la perte et ajuster des millions ou des milliards de paramètres pendant des heures. Ici, le modèle inspecte son état interne, diagnostique ce qu’il appelle une boucle et applique une correction ciblée. La note y voit une voie rapide pour que l’IA améliore l’IA, qui contourne entièrement la descente de gradient.
Qwen est la famille de modèles développée par Alibaba, l’une des plus grandes entreprises technologiques chinoises, et ses versions à poids ouverts en ont fait une base courante pour les chercheurs et les amateurs du monde entier. Le problème de boucle n’est pas propre à Qwen. Les modèles de raisonnement à longues chaînes de pensée de plusieurs laboratoires ont montré une tendance à trop réfléchir, à consommer des tokens en étapes redondantes et parfois à ne pas savoir s’arrêter. La consommation de tokens a aussi un coût : chaque millier supplémentaire est facturé en calcul.
Si le résultat tient, les implications vont dans deux directions. D’un côté, la maintenance des modèles devient moins chère et plus précise — un modèle pourrait corriger ses propres modes de défaillance récurrents sans cycle complet de réentraînement. De l’autre, la frontière entre maintenir un modèle et amplifier ses capacités commence à s’estomper. Un système capable de lire et de réécrire ses propres poids est un système qui peut, en principe, changer ce qu’il est. La note le dit : la ligne entre maintenance du modèle et montée en capacité devient floue.
L’affirmation s’accompagne de réserves. Un seul cas rapporté de boucle brisée ne prouve pas une méthode générale. Savoir si l’édition se généralise — si le modèle raisonne toujours correctement sur d’autres problèmes après la modification des poids — est la question à laquelle tout résultat de ce type doit répondre. Le chiffre de 0,016 % frappe précisément parce qu’il est petit, mais de petites éditions peuvent avoir des effets importants et imprévisibles ailleurs dans un réseau.
Le contexte plus large est une période chargée pour la recherche chinoise en IA. Ces dernières semaines, des équipes ont publié des travaux sur des agents qui s’auto-apprennent en boucle, sur des moteurs d’inférence open source et sur des modèles entraînés entièrement sur des puces nationales. L’automodification se situe à l’extrémité la plus spéculative de ce spectre, mais elle attire l’attention parce qu’elle s’attaque à un vrai casse-tête opérationnel : des modèles qui gaspillent des tokens sans avancer.
Pour le lecteur international, l’essentiel est que la frontière de l’amélioration des modèles s’élargit au-delà des grands entraînements. L’édition au niveau des poids, l’autodiagnostic et la rupture de boucles deviennent des sujets de recherche à part entière. Le prochain signal à surveiller est la réplication : des groupes indépendants parviendront-ils à reproduire le correctif sur d’autres modèles et à montrer que le réseau édité reste stable sur diverses tâches, et pas seulement sur le problème qui a motivé l’édition ?