Eine Gewichtsanpassung von 0,016 % beendet Qwens Endlosschleife nach 30.000 Tokens
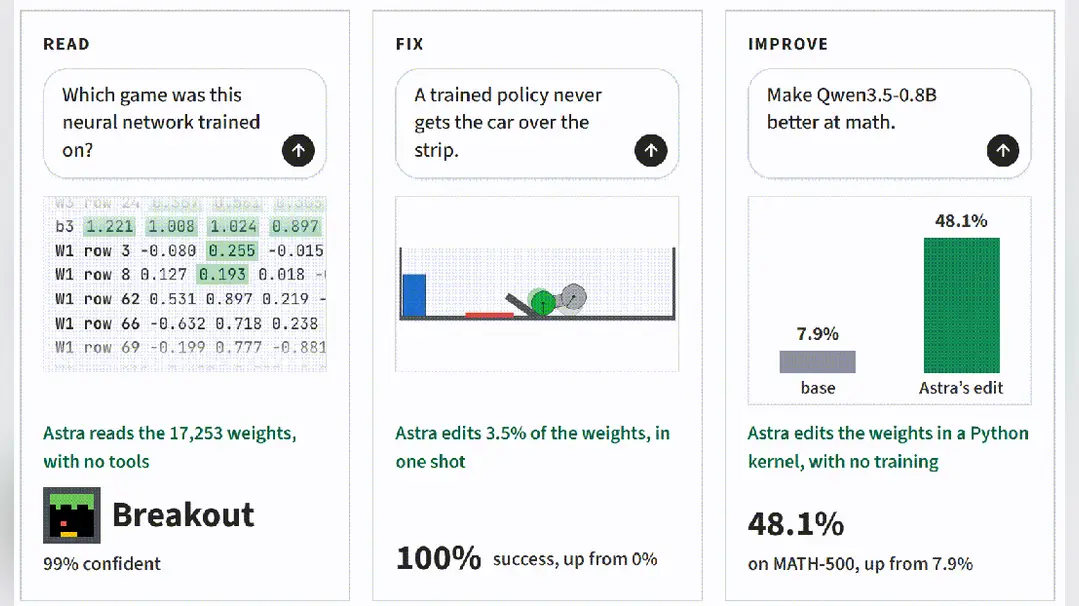
Ein Reasoning-Modell arbeitete an einer Matheaufgabe weit über 30.000 Tokens hinaus weiter, wiederholte dieselben Schritte und lieferte nie eine Antwort. Dieses Fehlermuster kennt jeder, der ein großes Sprachmodell schon einmal in eine Spirale hat laufen sehen: mehr Denken, kein Fortschritt. Die in einem viel geteilten chinesischen Fachbeitrag beschriebene Lösung war kein neuer Trainingslauf, sondern ein chirurgischer Eingriff in einen winzigen Bruchteil der Modellparameter – laut Darstellung rund 0,016 % der Gewichte.
Der Mechanismus ist der interessante Teil. Dasselbe Modell diente sowohl dazu, seine eigenen Gewichte zu lesen, als auch dazu, sie umzuschreiben. Üblicherweise bedeutet die Verbesserung eines Modells Gradientenabstieg: Beispiele einspeisen, den Verlust berechnen und über viele Stunden Millionen oder Milliarden Parameter justieren. Hier prüft das Modell seinen internen Zustand, diagnostiziert, was es eine Schleife nennt, und nimmt eine gezielte Korrektur vor. Der Beitrag beschreibt dies als Abkürzungskanal dafür, dass KI sich selbst verbessert, unter vollständiger Umgehung des Gradientenabstiegs.
Qwen ist die Modellfamilie des chinesischen Technologiekonzerns Alibaba, und ihre Veröffentlichungen mit offenen Gewichten haben sie weltweit zu einer gängigen Basis für Forscher und Hobbyisten gemacht. Das Schleifenproblem ist nicht auf Qwen beschränkt. Reasoning-Modelle mit langen Gedankenketten aus mehreren Labors neigen zum Überdenken, verbrauchen Tokens für redundante Schritte und hören mitunter nicht auf. Der Tokenverbrauch ist auch ein Kostenfaktor: Jedes zusätzliche Tausend wird als Rechenleistung abgerechnet.
Hält das Ergebnis stand, wirkt es in zwei Richtungen. Einerseits wird die Modellpflege billiger und präziser – ein Modell könnte seine wiederkehrenden Fehlermuster ohne vollständigen Neu-Trainingszyklus selbst beheben. Andererseits beginnt die Grenze zwischen Pflege eines Modells und Ausbau seiner Fähigkeiten zu verschwimmen. Ein System, das seine eigenen Gewichte lesen und umschreiben kann, ist ein System, das im Prinzip ändern kann, was es ist. Der Beitrag sagt es selbst: Die Linie zwischen Modellpflege und Skalierung der Fähigkeiten wird unscharf.
Die Behauptung kommt mit Einschränkungen. Ein einzelner gemeldeter Fall einer durchbrochenen Schleife ist kein Beleg für eine allgemeine Methode. Ob der Eingriff verallgemeinerbar ist – ob das Modell nach der Gewichtsänderung bei anderen Problemen weiterhin korrekt denkt –, ist die Frage, die jedes solche Ergebnis beantworten muss. Die Zahl 0,016 % fällt gerade deshalb auf, weil sie klein ist, doch kleine Änderungen können anderswo im Netz große, unvorhersehbare Wirkungen haben.
Der größere Kontext ist eine arbeitsreiche Phase der chinesischen KI-Forschung. In den vergangenen Wochen haben Teams Arbeiten zu Agenten veröffentlicht, die sich in Schleifen selbst unterrichten, zu quelloffenen Inferenz-Engines und zu Modellen, die vollständig auf heimischen Chips trainiert wurden. Selbstmodifikation liegt am spekulativeren Ende dieses Spektrums, zieht aber Aufmerksamkeit auf sich, weil sie ein echtes operatives Problem adressiert: Modelle, die Tokens verbrauchen, ohne voranzukommen.
Für internationale Leser lautet die praktische Erkenntnis, dass sich die Grenze der Modellverbesserung über größere Trainingsläufe hinaus verschiebt. Gewichtsediting, Selbstdiagnose und das Durchbrechen von Schleifen werden zu eigenständigen Forschungsthemen. Das nächste Signal ist die Replikation: ob unabhängige Gruppen den Fix auf andere Modelle übertragen können und zeigen, dass das bearbeitete Netz über verschiedene Aufgaben hinweg stabil bleibt – nicht nur bei dem Problem, das den Eingriff ausgelöst hat.