LongCat-2.5 de Meituan met en ligne un agent de 1,6 billion de paramètres
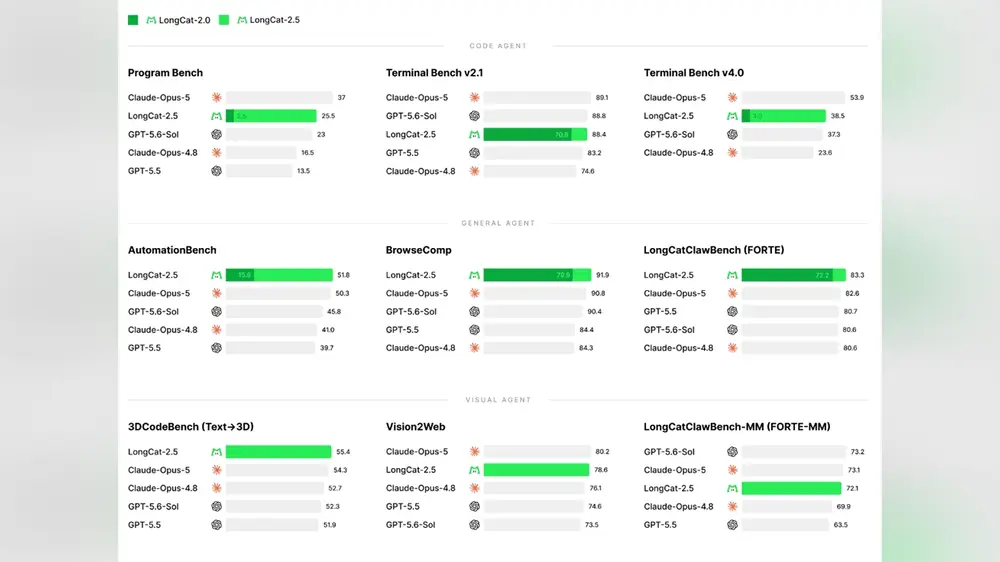
L’équipe LongCat de Meituan a publié LongCat-2.5 le 2 novembre, un modèle qu’elle décrit comme nativement multimodal et conçu pour des tâches d’agent à long horizon : des travaux où une IA doit planifier, utiliser des outils et poursuivre sur de nombreuses étapes plutôt que répondre à une seule question. Le chiffre qui fait la une est la taille : 1,6 billion de paramètres au total, avec environ 48 milliards activés pour chaque token traité par le modèle.
Cet écart entre paramètres totaux et actifs est la clé pour lire l’annonce. LongCat-2.5 semble recourir à une architecture de mélange d’experts, où un très vaste réservoir de paramètres existe mais seule une petite fraction est activée pour un token donné. L’approche permet aux laboratoires d’afficher une capacité énorme tout en rapprochant le coût de calcul de chaque réponse de celui d’un modèle bien plus petit. C’est désormais la manière standard de construire les systèmes de pointe, et cela signifie que le nombre de paramètres en dit moins qu’avant sur la vitesse réelle.
Meituan affirme que la nouvelle version renforce deux aspects par rapport à LongCat-2.0 : la compréhension visuelle native et le codage agentique. La compréhension visuelle native signifie que les images sont traitées à l’intérieur du modèle plutôt que transmises à un module de vision distinct ajouté après coup. Sur le plan technique, l’équipe représente les signaux visuels sous forme de tokens discrets à plusieurs niveaux, poursuivant une approche héritée du modèle précédent. Le codage agentique couvre le type de travail où un modèle écrit et exécute du code, vérifie le résultat et itère : la boucle qui sous-tend la plupart des outils logiciels d’IA actuels.
La publication est déjà partiellement utilisable. L’expérience en ligne et l’accès à l’API ont ouvert avec l’annonce, tandis que les poids du modèle doivent apparaître bientôt sur GitHub et HuggingFace. Cette séquence — hébergé d’abord, poids ensuite — est devenue courante chez les laboratoires chinois : elle permet aux développeurs de tester le modèle immédiatement tandis que l’entreprise garde un certain contrôle sur la distribution jusqu’à la publication ouverte.
Meituan est surtout connue hors de Chine comme application de livraison de repas et de services locaux, mais elle construit depuis des années une branche de recherche interne en IA. LongCat donne à l’entreprise son propre modèle plutôt qu’une dépendance à l’API d’un autre, un schéma de plus en plus visible parmi les entreprises chinoises d’internet grand public qui veulent intégrer des fonctions d’IA dans les achats, les réservations et la livraison sans payer un tiers à chaque appel.
Le calendrier n’est pas fortuit. Le cycle d’actualité IA du même jour comprenait DeepSeek ouvrant le code d’une architecture de Super-agent et des annonces de commerce électronique de tokens d’IA comme catégorie de produit à part entière pendant le festival shopping du Double 11. La concurrence chinoise en IA est passée des scores bruts aux benchmarks aux agents qui accomplissent des tâches à plusieurs étapes, et LongCat-2.5 vise précisément cette compétition.
Ce qui reste non démontré, c’est ce que les chiffres ne peuvent trancher : si un agent de 1,6 billion de paramètres reste fiable pendant des heures de travail, et si la facture de calcul a du sens pour les marges d’une entreprise de livraison. Les tests indépendants compteront plus que le billet de lancement. Le prochain jalon concret est la publication promise des poids sur GitHub et HuggingFace, quand des développeurs extérieurs pourront exécuter LongCat-2.5 eux-mêmes et rapporter ce qu’il fait réellement.