DeepSeek rende open source DeepInfer, il motore dietro il proprio traffico chat
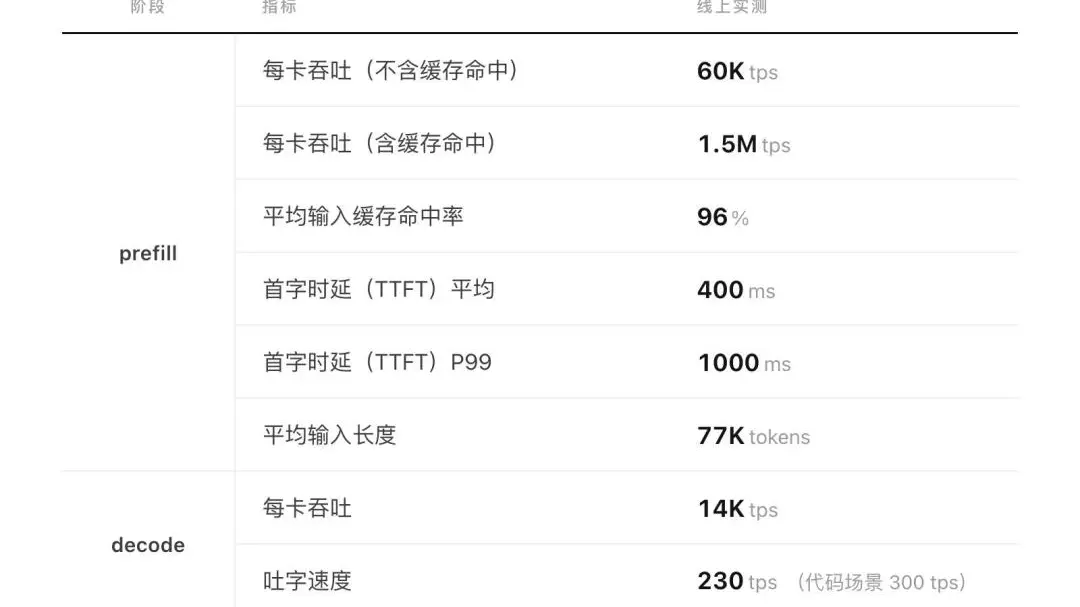
DeepSeek ha pubblicato DeepInfer, il framework di inferenza interno che alimenta il serving dei modelli su scala produttiva, con la permissiva licenza Apache 2.0 il 20 ottobre, insieme a deepseek-recipe, un componente complementare per la codifica e decodifica dei token. Il rilascio supporta attualmente DeepSeek-V4.1-Flash.
Il framework include operatori ad alte prestazioni e un motore di ottimizzazione, e aggiunge inferenza distribuita, decodifica speculativa, output strutturato e una tecnica di risparmio di memoria che l’azienda chiama SWA Bounded Replay. Funziona sia su hardware Nvidia che sui chip Ascend di Huawei, un dettaglio importante per gli sviluppatori cinesi che non possono fare affidamento su GPU importate.
DeepInfer segue un pattern di DeepSeek: l’azienda ha già aperto i pesi dei suoi modelli, i suoi strumenti del compilatore TileLang e la sua libreria di operatori di inferenza. Pubblicare il layer di serving consente agli ingegneri esterni di riprodurre i guadagni di efficienza dell’azienda invece di decodificarli a ritroso, e offre ai team più piccoli un percorso pronto all’uso per eseguire modelli di grandi dimensioni a basso costo.
La mossa alza anche silenziosamente l’asticella per i rivali. Il costo di inferenza, non la qualità grezza del modello, decide sempre più quali prodotti AI sopravvivono su larga scala, e DeepSeek sta consegnando il suo vantaggio di costo a chiunque lo voglia.