DeepSeek abre o código do DeepInfer, o motor por trás do seu próprio tráfego de chat
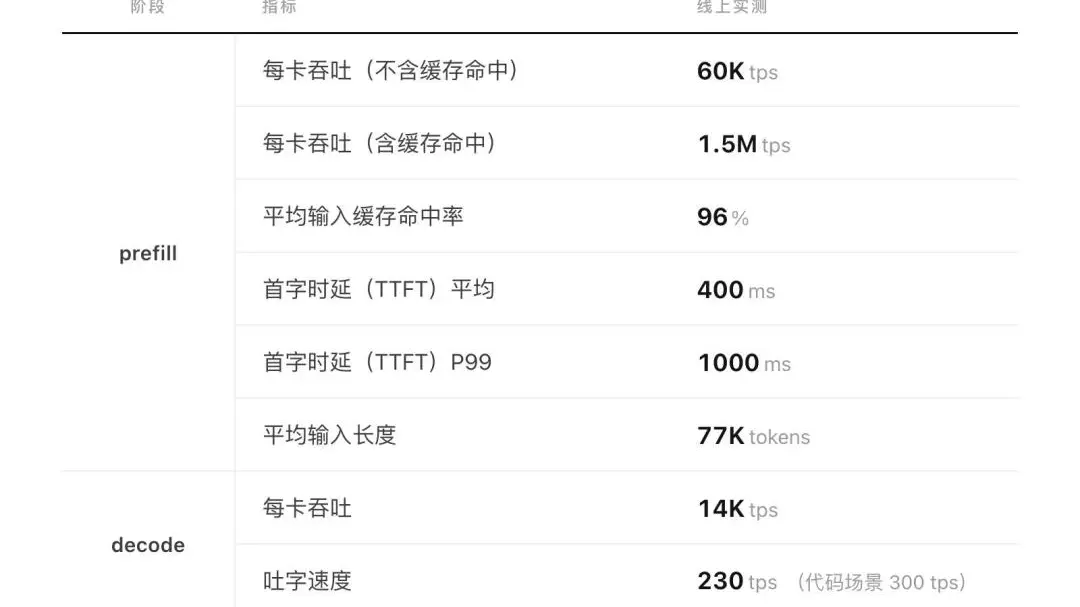
A DeepSeek publicou o DeepInfer, o framework de inferência interno que alimenta sua serving de modelos em escala de produção, sob a permissiva licença Apache 2.0 em 20 de outubro, junto com o deepseek-recipe, um componente complementar de codificação e decodificação de tokens. O lançamento atualmente suporta o DeepSeek-V4.1-Flash.
O framework reúne operadores de alto desempenho e um motor de otimização, e adiciona inferência distribuída, decodificação especulativa, saída estruturada e uma técnica de economia de memória que a empresa chama de SWA Bounded Replay. Ele roda tanto em hardware Nvidia quanto nos chips Ascend da Huawei, um detalhe que importa para desenvolvedores chineses que não podem contar com GPUs importadas.
O DeepInfer segue um padrão da DeepSeek: a empresa já abriu os pesos de seus modelos, suas ferramentas de compilação TileLang e sua biblioteca de operadores de inferência. Publicar a camada de serving permite que engenheiros externos reproduzam os ganhos de eficiência da empresa em vez de fazer engenharia reversa, e oferece às equipes menores um caminho pronto para executar modelos grandes de forma barata.
O movimento também eleva discretamente a barra para os rivais. O custo de inferência, e não a qualidade bruta do modelo, decide cada vez mais quais produtos de IA sobrevivem em escala, e a DeepSeek está entregando sua vantagem de custo a quem quiser.