DeepSeek libera DeepInfer, el motor detrás de su propio tráfico de chat
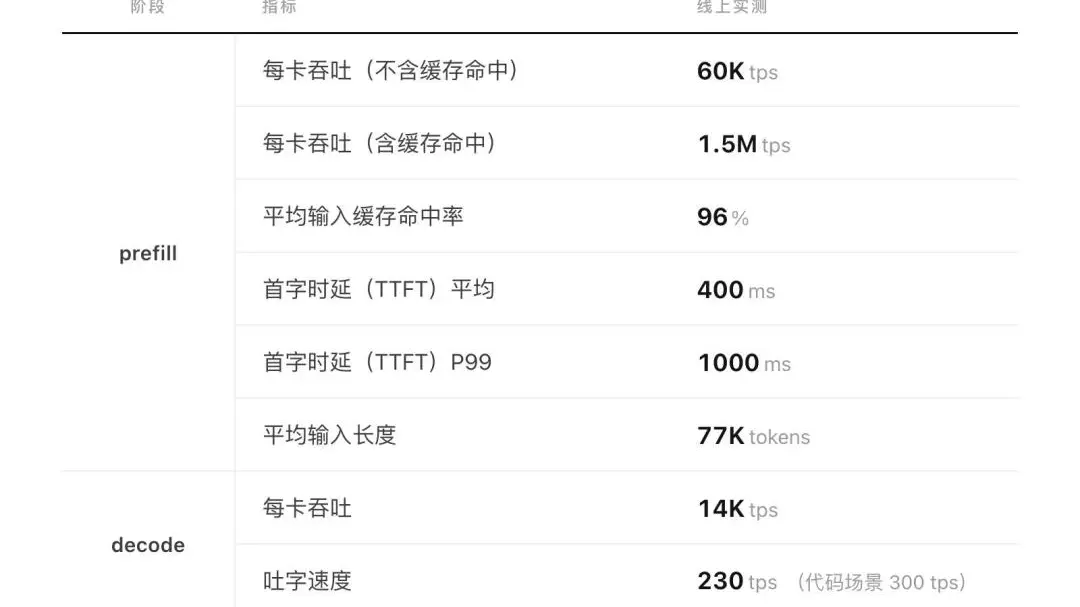
DeepSeek publicó DeepInfer, el framework de inferencia interno que impulsa su servicio de modelos a escala de producción, bajo la permisiva licencia Apache 2.0 el 20 de octubre, junto con deepseek-recipe, un componente complementario de codificación y decodificación de tokens. La versión actualmente soporta DeepSeek-V4.1-Flash.
El framework incluye operadores de alto rendimiento y un motor de optimización, y añade inferencia distribuida, decodificación especulativa, salida estructurada y una técnica de ahorro de memoria que la compañía llama SWA Bounded Replay. Funciona tanto en hardware de Nvidia como en los chips Ascend de Huawei, un detalle que importa para los desarrolladores chinos que no pueden depender de GPUs importadas.
DeepInfer sigue un patrón de DeepSeek: ya ha abierto los pesos de sus modelos, sus herramientas de compilación TileLang y su biblioteca de operadores de inferencia. Publicar la capa de servicio permite a ingenieros externos reproducir las ganancias de eficiencia de la compañía en lugar de hacer ingeniería inversa, y ofrece a equipos más pequeños un camino listo para ejecutar modelos grandes de forma económica.
El movimiento también eleva discretamente el listón para los rivales. El costo de inferencia, y no la calidad bruta del modelo, decide cada vez más qué productos de IA sobreviven a escala, y DeepSeek está entregando su ventaja de costos a quien la quiera.