DeepSeek maakt DeepInfer open source, de engine achter zijn eigen chattraffic
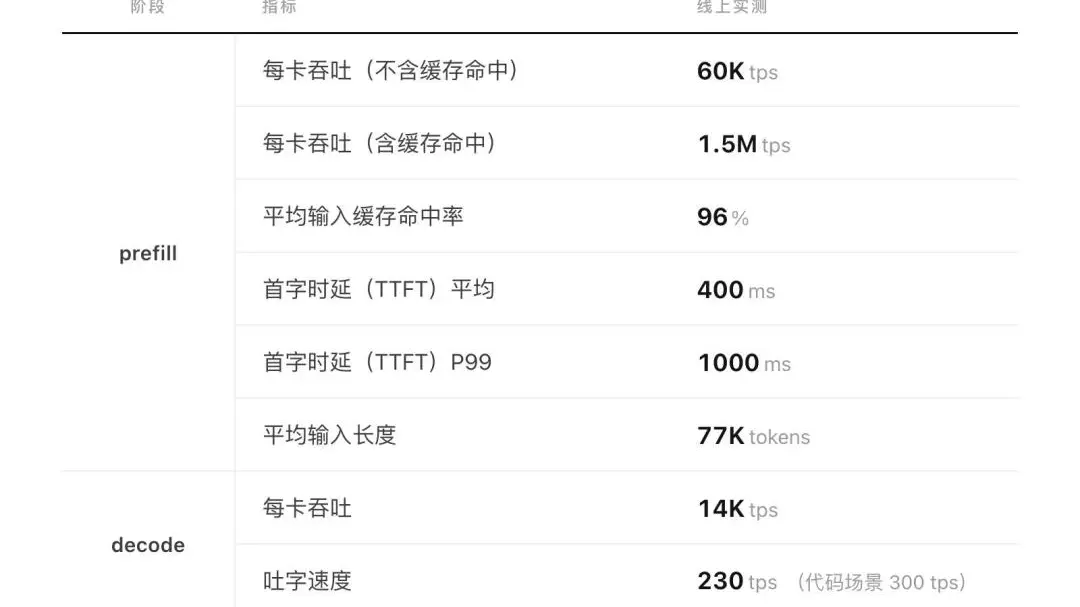
DeepSeek heeft op 20 oktober DeepInfer gepubliceerd, het interne inferentieframework dat zijn modellevering op productieschaal aandrijft, onder de permissieve Apache 2.0-licentie, samen met deepseek-recipe, een bijbehorende component voor het coderen en decoderen van tokens. De release ondersteunt momenteel DeepSeek-V4.1-Flash.
Het framework bundelt hoogwaardige operators en een optimalisatie-engine, en voegt gedistribueerde inferentie, speculatieve decodering, gestructureerde output en een geheugenbesparende techniek toe die het bedrijf SWA Bounded Replay noemt. Het draait zowel op Nvidia-hardware als op Huawei’s Ascend-chips, een detail dat belangrijk is voor Chinese ontwikkelaars die niet op geïmporteerde GPU’s kunnen vertrouwen.
DeepInfer volgt een patroon van DeepSeek: het bedrijf heeft al zijn modelgewichten, zijn TileLang-compilertooling en zijn inferentie-operatorbibliotheek opengesteld. Door de servinglaag te publiceren, kunnen externe ingenieurs de efficiëntiewinsten van het bedrijf reproduceren in plaats van ze reverse-engineeren, en krijgen kleinere teams een kant-en-klare route om grote modellen goedkoop te draaien.
De zet verhoogt ook stilzwijgend de lat voor rivalen. Inferentiekosten, niet de ruwe modelkwaliteit, bepalen steeds vaker welke AI-producten op schaal overleven, en DeepSeek geeft zijn kostenvoordeel weg aan iedereen die het wil.