DeepSeek open-source DeepInfer, le moteur derrière son propre trafic de chat
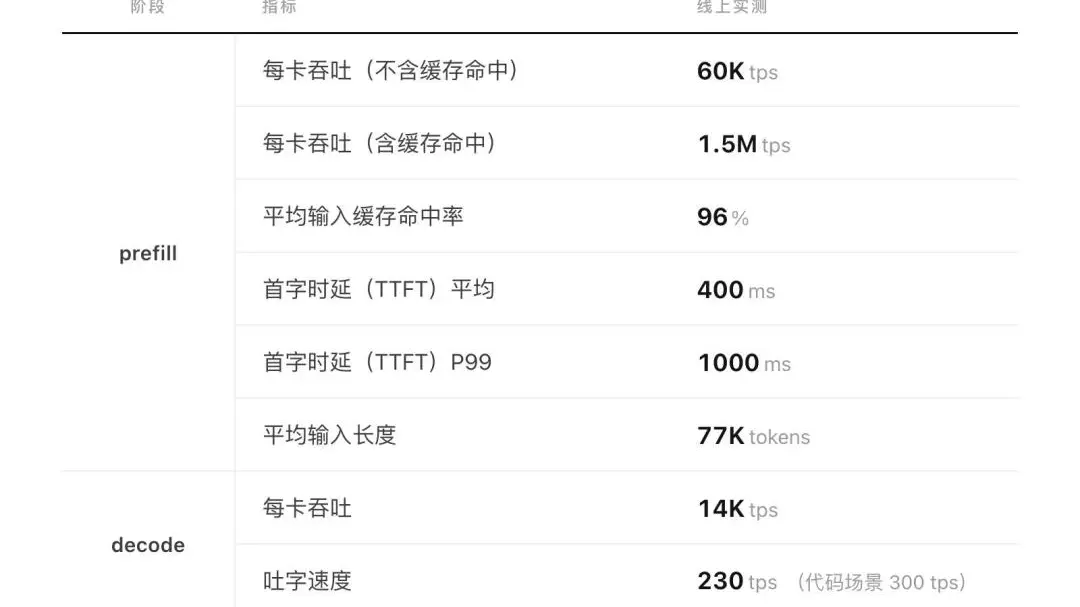
DeepSeek a publié DeepInfer, le framework d’inférence interne qui alimente son service de modèles à l’échelle de la production, sous la licence permissive Apache 2.0 le 20 octobre, avec deepseek-recipe, un composant complémentaire d’encodage et de décodage de tokens. La version prend actuellement en charge DeepSeek-V4.1-Flash.
Le framework regroupe des opérateurs hautes performances et un moteur d’optimisation, et ajoute l’inférence distribuée, le décodage spéculatif, la sortie structurée et une technique d’économie de mémoire que l’entreprise appelle SWA Bounded Replay. Il fonctionne à la fois sur le matériel Nvidia et sur les puces Ascend de Huawei, un détail qui compte pour les développeurs chinois qui ne peuvent pas compter sur des GPU importés.
DeepInfer suit un schéma chez DeepSeek : l’entreprise a déjà ouvert les poids de ses modèles, ses outils de compilation TileLang et sa bibliothèque d’opérateurs d’inférence. Publier la couche de service permet aux ingénieurs externes de reproduire les gains d’efficacité de l’entreprise au lieu de les rétro-ingénierer, et offre aux petites équipes un moyen tout prêt d’exécuter de grands modèles à moindre coût.
Ce geste relève aussi discrètement la barre pour les concurrents. Le coût d’inférence, et non la qualité brute du modèle, décide de plus en plus quels produits d’IA survivent à l’échelle, et DeepSeek offre son avantage de coût à qui veut le prendre.