DeepSeek veröffentlicht DeepInfer als Open Source – die Engine hinter dem eigenen Chat-Traffic
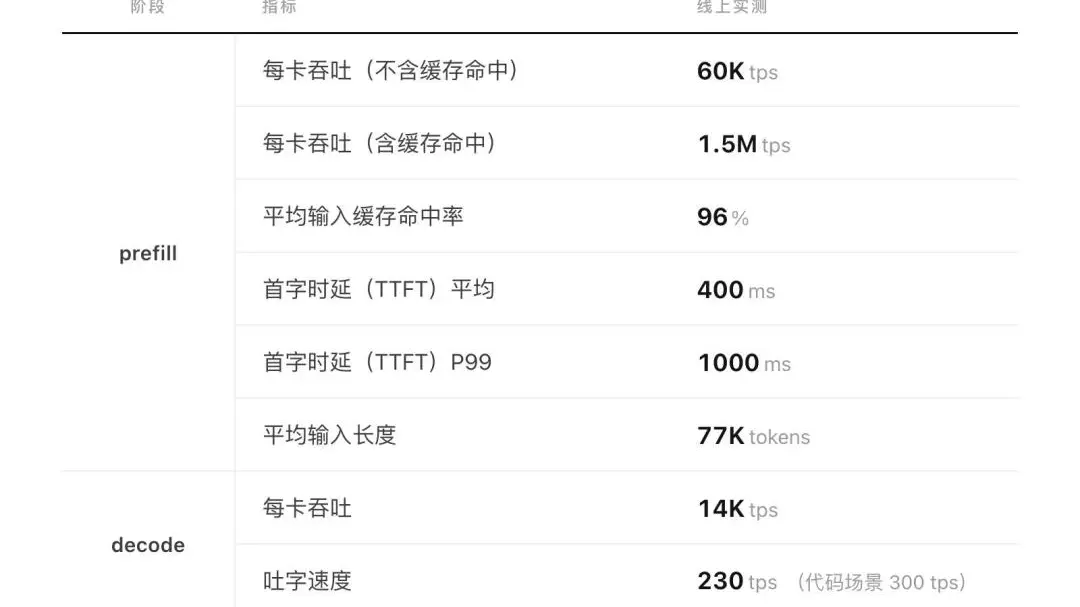
DeepSeek hat am 20. Oktober DeepInfer, das interne Inferenz-Framework, das seine Modellbereitstellung in Produktionsmaßstab antreibt, unter der permissiven Apache-2.0-Lizenz veröffentlicht, zusammen mit deepseek-recipe, einer begleitenden Komponente zur Token-Kodierung und -Dekodierung. Die Veröffentlichung unterstützt derzeit DeepSeek-V4.1-Flash.
Das Framework bündelt Hochleistungs-Operatoren und eine Optimierungs-Engine und ergänzt verteilte Inferenz, spekulative Dekodierung, strukturierte Ausgabe und eine speichersparende Technik, die das Unternehmen SWA Bounded Replay nennt. Es läuft sowohl auf Nvidia-Hardware als auch auf Huaweis Ascend-Chips – ein Detail, das für chinesische Entwickler wichtig ist, die nicht auf importierte GPUs zurückgreifen können.
DeepInfer folgt einem Muster bei DeepSeek: Das Unternehmen hat bereits seine Modellgewichte, seine TileLang-Compiler-Tools und seine Inferenz-Operator-Bibliothek geöffnet. Die Veröffentlichung der Serving-Schicht ermöglicht es externen Ingenieuren, die Effizienzgewinne des Unternehmens nachzuvollziehen, statt sie rückwärts zu entwickeln, und bietet kleineren Teams einen fertigen Weg, große Modelle kostengünstig zu betreiben.
Der Schritt hebt auch stillschweigend die Messlatte für Konkurrenten. Inferenzkosten und nicht die rohe Modellqualität entscheiden zunehmend darüber, welche KI-Produkte im Maßstab überleben, und DeepSeek gibt seinen Kostenvorteil jedem, der ihn nutzen will.