Meituans LongCat-2.5 bringt einen Agenten mit 1,6 Billionen Parametern online
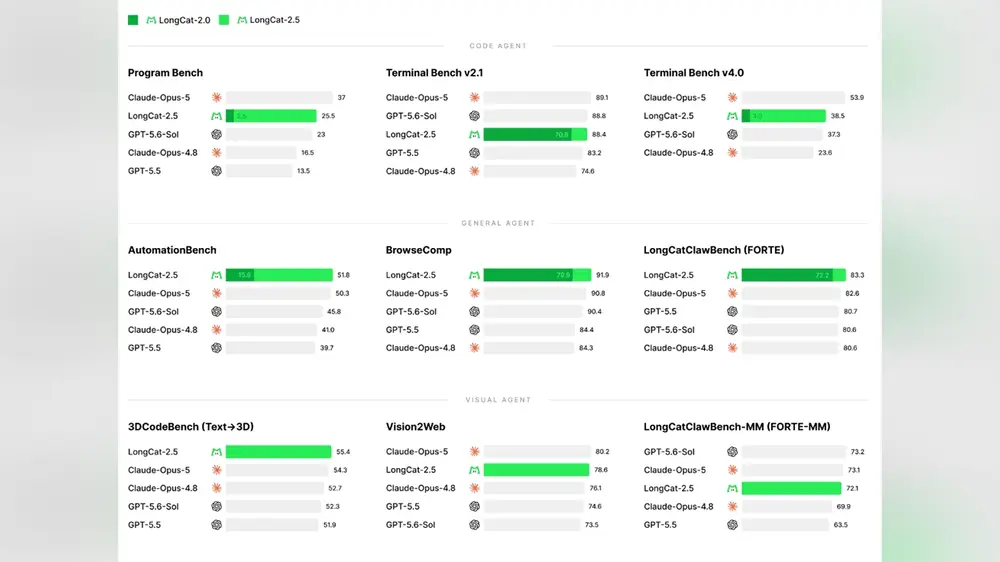
Meituans LongCat-Team hat am 2. November LongCat-2.5 veröffentlicht, ein Modell, das es als nativ multimodal beschreibt und für langfristige Agentenaufgaben entwickelt hat – Arbeiten, bei denen eine KI planen, Werkzeuge nutzen und über viele Schritte hinweg weiterarbeiten muss, statt eine einzelne Frage zu beantworten. Die Schlagzeile ist die Größe: 1,6 Billionen Parameter insgesamt, davon rund 48 Milliarden aktiviert für jedes Token, das das Modell verarbeitet.
Diese Lücke zwischen Gesamt- und aktiven Parametern ist der Schlüssel zur Einordnung der Angabe. LongCat-2.5 scheint ein Mixture-of-Experts-Design zu nutzen, bei dem ein sehr großer Parameterpool existiert, aber für jedes Token nur ein kleiner Teil aktiviert wird. Der Ansatz erlaubt es Laboren, enorme Kapazität zu bewerben und zugleich die Rechenkosten jeder Antwort näher an die eines viel kleineren Modells zu bringen. Er ist inzwischen die Standardbauweise für Frontier-Systeme – und bedeutet, dass Parameterzahlen weniger über die reale Geschwindigkeit aussagen als früher.
Meituan zufolge stärkt die neue Version zwei Dinge gegenüber LongCat-2.0: natives visuelles Verständnis und agentisches Programmieren. Natives visuelles Verständnis heißt, dass Bilder im Modell selbst verarbeitet werden und nicht durch ein nachträglich angebautes separates Vision-Modul laufen. Technisch stellt das Team visuelle Signale als mehrstufige diskrete Token dar und führt damit einen Ansatz aus dem Vorgängermodell fort. Agentisches Programmieren umfasst Arbeiten, bei denen ein Modell Code schreibt und ausführt, das Ergebnis prüft und iteriert – die Schleife hinter den meisten aktuellen KI-Softwarewerkzeugen.
Die Veröffentlichung ist bereits teilweise nutzbar. Online-Erfahrung und API-Zugang wurden mit der Ankündigung geöffnet, die Modellgewichte sollen bald auf GitHub und HuggingFace erscheinen. Diese Reihenfolge – erst gehostet, später die Gewichte – ist bei chinesischen Laboren üblich geworden: Entwickler können das Modell sofort testen, während das Unternehmen bis zur offenen Veröffentlichung eine gewisse Kontrolle über die Verbreitung behält.
Meituan ist außerhalb Chinas vor allem als App für Essenslieferungen und lokale Dienste bekannt, baut aber seit Jahren eine eigene KI-Forschungsabteilung auf. LongCat gibt dem Unternehmen ein eigenes Modell statt der Abhängigkeit von einer fremden API – ein Muster, das bei chinesischen Consumer-Internetfirmen zunehmend sichtbar ist, die KI-Funktionen in Einkauf, Buchung und Lieferung einbinden wollen, ohne für jeden Aufruf an Dritte zu zahlen.
Der Zeitpunkt ist kein Zufall. Zum KI-Nachrichtenzyklus desselben Tages gehörten DeepSeeks Open-Source-Veröffentlichung einer Super-Agenten-Architektur und E-Commerce-Angebote für KI-Token als eigene Produktkategorie während des Double-11-Shoppingfests. Der chinesische KI-Wettbewerb hat sich von rohen Benchmark-Werten hin zu Agenten bewegt, die mehrstufige Aufgaben erledigen, und LongCat-2.5 zielt genau auf diesen Wettstreit.
Unbewiesen bleibt, was Zahlen nicht klären können: ob ein Agent mit 1,6 Billionen Parametern über Stunden hinweg zuverlässig bleibt und ob die Rechenrechnung für die Margen eines Lieferunternehmens aufgeht. Unabhängige Tests werden mehr zählen als der Launch-Beitrag. Der nächste konkrete Prüfpunkt ist die versprochene Veröffentlichung der Gewichte auf GitHub und HuggingFace, wenn externe Entwickler LongCat-2.5 selbst ausführen und berichten können, was es tatsächlich leistet.