LongCat-2.5 de Meituan pone en línea un agente de 1,6 billones de parámetros
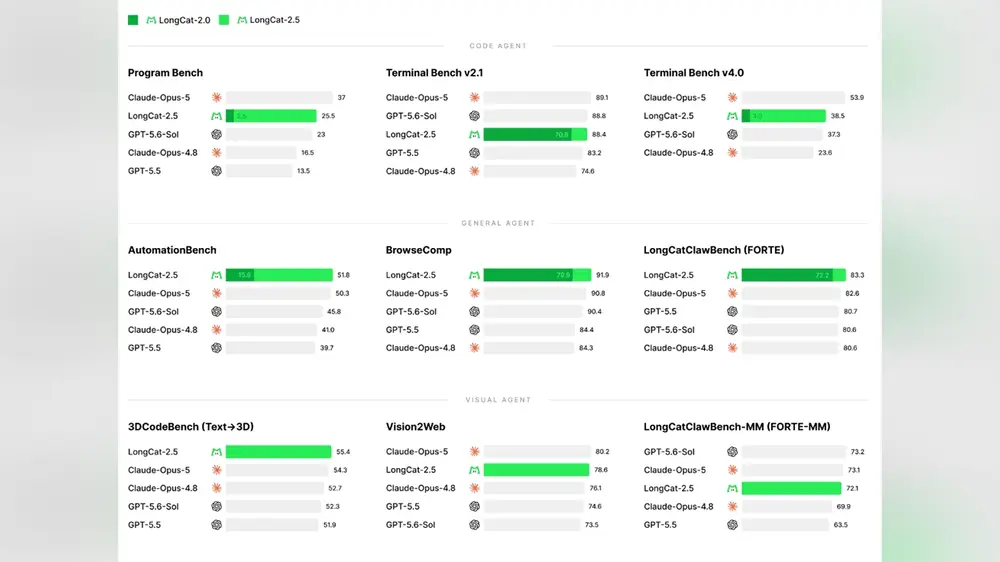
El equipo LongCat de Meituan lanzó LongCat-2.5 el 2 de noviembre, un modelo que describe como nativamente multimodal y concebido para tareas de agente de largo horizonte: trabajos en los que una IA debe planificar, usar herramientas y seguir avanzando a lo largo de muchos pasos en lugar de responder a una sola pregunta. La cifra que encabeza el anuncio es el tamaño: 1,6 billones de parámetros totales, con unos 48.000 millones activados por cada token que procesa el modelo.
Esa diferencia entre parámetros totales y activos es la clave para interpretar la afirmación. LongCat-2.5 parece emplear un diseño de mezcla de expertos, en el que existe un fondo muy amplio de parámetros pero solo se activa una pequeña porción para cada token. El enfoque permite a los laboratorios anunciar una capacidad enorme manteniendo el coste computacional de cada respuesta más cerca del de un modelo mucho más pequeño. Es ya la forma estándar de construir sistemas de frontera, y hace que el recuento de parámetros diga menos sobre la velocidad real de lo que decía antes.
Meituan afirma que la nueva versión refuerza dos aspectos respecto a LongCat-2.0: la comprensión visual nativa y la programación agéntica. La comprensión visual nativa significa que las imágenes se procesan dentro del modelo en lugar de pasar por un módulo de visión separado añadido después. En el plano técnico, el equipo representa las señales visuales como tokens discretos multinivel, continuando un enfoque heredado del modelo anterior. La programación agéntica abarca el tipo de trabajo en el que un modelo escribe y ejecuta código, comprueba el resultado e itera: el bucle que hay detrás de la mayoría de las herramientas de software de IA actuales.
El lanzamiento ya es utilizable en parte. La experiencia en línea y el acceso a la API se abrieron con el anuncio, mientras que los pesos del modelo aparecerán pronto en GitHub y HuggingFace. Esa secuencia —primero alojado, luego los pesos— se ha vuelto habitual entre los laboratorios chinos: permite a los desarrolladores probar el modelo de inmediato mientras la empresa mantiene cierto control sobre la distribución hasta que llegue la publicación abierta.
Meituan es más conocida fuera de China como aplicación de reparto de comida y servicios locales, pero lleva años construyendo un brazo interno de investigación en IA. LongCat le da a la empresa un modelo propio en lugar de depender de la API de otro, un patrón cada vez más visible entre las empresas chinas de internet de consumo que quieren integrar funciones de IA en compras, reservas y reparto sin pagar a un tercero por cada llamada.
El momento no es casual. El ciclo de noticias de IA del mismo día incluyó a DeepSeek abriendo el código de una arquitectura de Super-agente y listados de comercio electrónico de tokens de IA como categoría de producto independiente durante el festival de compras del Doble 11. La competencia china en IA ha pasado de las puntuaciones brutas en los benchmarks a los agentes que completan tareas de varios pasos, y LongCat-2.5 apunta directamente a esa contienda.
Lo que sigue sin demostrarse es lo que los números no pueden resolver: si un agente de 1,6 billones de parámetros se mantiene fiable durante horas de trabajo, y si la factura computacional tiene sentido para los márgenes de una empresa de reparto. Las pruebas independientes importarán más que la publicación de lanzamiento. El próximo punto de control concreto es la prometida publicación de los pesos en GitHub y HuggingFace, cuando desarrolladores externos puedan ejecutar LongCat-2.5 por sí mismos e informar de lo que realmente hace.