OpenAI afferma che la sua IA ha risolto 372 problemi matematici aperti. I matematici sono scettici
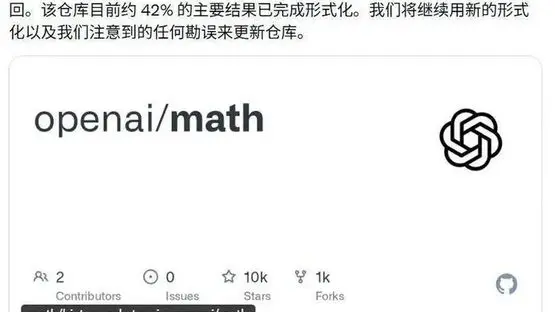
All’inizio di ottobre, OpenAI ha pubblicato 722 manoscritti matematici su GitHub, tutti generati da un singolo modello interno che l’azienda non ha mai reso pubblico. Secondo OpenAI, il sistema ha affrontato circa 4.000 problemi aperti in 17 rami della matematica — tra cui teoria dei numeri, geometria, probabilità e informatica teorica — e ha prodotto risultati su 372 di essi. L’annuncio è arrivato meno di tre mesi dopo che la matematica cinese Wang Hong ha vinto una Medaglia Fields, il più alto riconoscimento della disciplina, per il suo lavoro sulla versione tridimensionale della congettura di Kakegawa. Il modello di OpenAI, ha suggerito l’azienda, era andato una dimensione oltre.
È questa impostazione che ha fatto viaggiare il comunicato. La matematica è diventata un improbabile banco di prova per l’intelligenza artificiale, perché a differenza della scrittura di saggi o della generazione di immagini, una dimostrazione può essere verificata. Una dimostrazione corretta è corretta per sempre; una sbagliata può essere demolita da qualsiasi studente di dottorato competente. I vincitori della Medaglia Fields, non i reparti marketing, sono i giudici naturali.
Il problema è il volume. Settecentoventidue manoscritti non sono un articolo. Sono una piccola biblioteca, e leggerla richiede quel tipo di attenzione lenta e critica che non può essere esternalizzata alla stessa classe di modello che l’ha scritta. I matematici che hanno iniziato a esaminare i file descrivono un panorama misto: argomenti che sembrano plausibili fino a un passo specifico, definizioni che cambiano silenziosamente significato a metà, e occasionali risultati che appaiono genuinamente nuovi.
Gli scrittori scientifici cinesi sono stati più diretti. Un saggio ampiamente condiviso ha paragonato il rilascio alla scoperta di una montagna di rifiuti, con i ricercatori che si tappano il naso e setacciano in cerca d’oro. L’immagine è poco gentile, ma cattura il lavoro effettivo coinvolto. Qualcuno deve decidere, riga per riga, quali di quei 372 risultati dichiarati sopravvivono al contatto con un esperto umano.
Questo è un modello familiare nell’apprendimento automatico. I sistemi che generano soluzioni candidate superano di gran lunga gli esseri umani disponibili per verificarle, che si tratti di matematica, scoperta di farmaci o scienza dei materiali. La verifica diventa il collo di bottiglia, e il collo di bottiglia determina il valore reale dello strumento. Un modello che propone diecimila ipotesi è utile solo quanto il laboratorio che può testarle.
C’è anche una questione più profonda su cosa stia facendo il modello. I matematici distinguono tra trovare una dimostrazione e capire perché un teorema è vero. Una macchina può cercare una catena di passaggi validi senza cogliere la struttura che rende il risultato inevitabile, ed è quella struttura che permette agli umani di estendere un risultato a nuovi casi. Se i manoscritti di OpenAI contengono dimostrazioni valide ma nessuna intuizione, possono comunque essere utili — ma non cambieranno, da soli, il modo in cui il campo pensa.
Per ora, la risposta onesta è che nessuno lo sa. I manoscritti sono pubblici, le affermazioni sono abbastanza specifiche da essere verificate, e la verifica è iniziata. È così che la matematica ha sempre risolto le dispute, ed è un processo più lento di un annuncio di prodotto.
Ciò che l’episodio dimostra è che le aziende di IA hanno deciso che la matematica è l’arena in cui possono fare le loro affermazioni più credibili. Il campo offre qualcosa di raro nel dibattito sull’IA: un verdetto che non dipende dall’opinione di nessuno. Se anche solo una frazione di quei 372 risultati regge, il rilascio sarà ricordato come una pietra miliare. Se la maggior parte crolla sotto esame, sarà ricordato come una lezione sul divario tra generare testo e produrre conoscenza.