OpenAI affirme que son IA a résolu 372 problèmes mathématiques ouverts. Les mathématiciens sont sceptiques
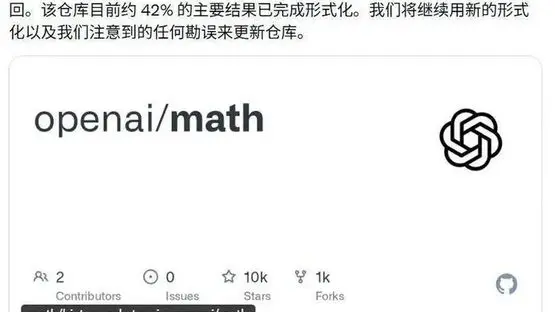
Début octobre, OpenAI a publié 722 manuscrits mathématiques sur GitHub, tous générés par un seul modèle interne que l’entreprise n’a jamais rendu public. Selon OpenAI, le système s’est attaqué à environ 4 000 problèmes ouverts dans 17 branches des mathématiques — théorie des nombres, géométrie, probabilités et informatique théorique, entre autres — et a produit des résultats sur 372 d’entre eux. L’annonce est tombée moins de trois mois après que la mathématicienne chinoise Wang Hong a remporté une médaille Fields, la plus haute distinction de la discipline, pour ses travaux sur la version tridimensionnelle de la conjecture de Kakegawa. Le modèle d’OpenAI, a suggéré l’entreprise, était allé une dimension plus loin.
C’est ce cadrage qui a fait circuler la publication. Les mathématiques sont devenues un terrain d’essai improbable pour l’intelligence artificielle, car contrairement à la rédaction d’essais ou à la génération d’images, une preuve peut être vérifiée. Une preuve correcte est correcte pour toujours ; une preuve erronée peut être démolie par n’importe quel étudiant de troisième cycle compétent. Les lauréats de la médaille Fields, et non les services marketing, sont les arbitres naturels.
Le problème, c’est le volume. Sept cent vingt-deux manuscrits, ce n’est pas un article. C’est une petite bibliothèque, et sa lecture exige ce type d’attention lente et contradictoire qui ne peut pas être déléguée à la même classe de modèle qui l’a écrite. Les mathématiciens qui ont commencé à parcourir les fichiers décrivent un paysage mitigé : des arguments qui semblent plausibles jusqu’à une étape précise, des définitions qui changent discrètement de sens à mi-parcours, et quelques résultats qui semblent véritablement nouveaux.
Les vulgarisateurs scientifiques chinois ont été plus directs. Un essai largement partagé a comparé la publication à la découverte d’une montagne de déchets, avec des chercheurs se bouchant le nez et fouillant dedans à la recherche d’or. L’image est peu charitable, mais elle capture le travail réel impliqué. Quelqu’un doit décider, ligne par ligne, lesquels de ces 372 résultats revendiqués survivent au contact d’un expert humain.
C’est un schéma familier en apprentissage automatique. Les systèmes qui génèrent des solutions candidates dépassent largement les humains disponibles pour les vérifier, que ce soit en mathématiques, en découverte de médicaments ou en science des matériaux. La vérification devient le goulot d’étranglement, et le goulot d’étranglement détermine la valeur réelle de l’outil. Un modèle qui propose dix mille hypothèses n’est utile que dans la mesure où le laboratoire peut les tester.
Il y a aussi une question plus profonde sur ce que fait le modèle. Les mathématiciens distinguent le fait de trouver une preuve et celui de comprendre pourquoi un théorème est vrai. Une machine peut chercher une chaîne d’étapes valides sans saisir la structure qui rend le résultat inévitable, et c’est cette structure qui permet aux humains d’étendre un résultat à de nouveaux cas. Si les manuscrits d’OpenAI contiennent des preuves valides mais aucune intuition, ils peuvent encore être utiles — mais ils ne changeront pas, à eux seuls, la façon dont le domaine pense.
Pour l’instant, la réponse honnête est que personne ne sait. Les manuscrits sont publics, les affirmations sont suffisamment précises pour être vérifiées, et la vérification a commencé. C’est ainsi que les mathématiques ont toujours réglé les différends, et c’est un processus plus lent qu’une annonce de produit.
Ce que l’épisode montre, en revanche, c’est que les entreprises d’IA ont décidé que les mathématiques sont l’arène où elles peuvent faire leurs affirmations les plus crédibles. Le domaine offre quelque chose de rare dans le débat sur l’IA : un verdict qui ne dépend de l’opinion de personne. Si même une fraction de ces 372 résultats tient, la publication restera dans les mémoires comme un jalon. Si la plupart s’effondrent à l’examen, elle restera comme une leçon sur l’écart entre générer du texte et produire de la connaissance.