OpenAI behauptet, seine KI habe 372 offene Mathematikprobleme gelöst. Mathematiker sind skeptisch
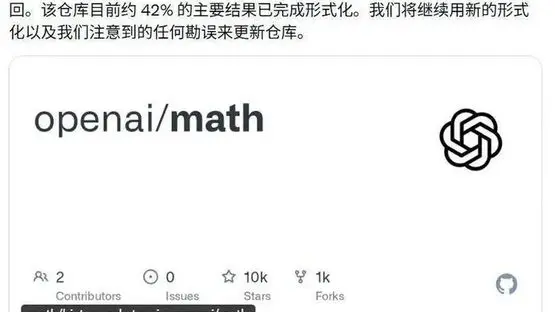
Anfang Oktober veröffentlichte OpenAI 722 mathematische Manuskripte auf GitHub, alle von einem einzigen internen Modell generiert, das das Unternehmen nie der Öffentlichkeit zugänglich gemacht hat. Laut OpenAI bearbeitete das System etwa 4.000 offene Probleme in 17 Teilgebieten der Mathematik – darunter Zahlentheorie, Geometrie, Wahrscheinlichkeitstheorie und theoretische Informatik – und erzielte Ergebnisse bei 372 davon. Die Ankündigung erfolgte weniger als drei Monate, nachdem die chinesische Mathematikerin Wang Hong eine Fields-Medaille gewonnen hatte, die höchste Auszeichnung der Disziplin, für ihre Arbeit an der dreidimensionalen Version der Kakegawa-Vermutung. Das Modell von OpenAI, so deutete das Unternehmen an, sei eine Dimension weiter gegangen.
Diese Rahmung sorgte dafür, dass die Veröffentlichung weite Verbreitung fand. Die Mathematik ist zu einem unwahrscheinlichen Prüfstein für künstliche Intelligenz geworden, denn anders als beim Verfassen von Aufsätzen oder der Bilderzeugung lässt sich ein Beweis überprüfen. Ein korrekter Beweis ist für immer korrekt; ein falscher kann von jedem kompetenten Doktoranden widerlegt werden. Fields-Medaillen-Gewinner, nicht Marketingabteilungen, sind die natürlichen Schiedsrichter.
Das Problem ist die Menge. Siebenhundertzweiundzwanzig Manuskripte sind keine Abhandlung. Es ist eine kleine Bibliothek, und ihre Lektüre erfordert jene langsame, kritische Aufmerksamkeit, die nicht an dieselbe Art von Modell ausgelagert werden kann, die sie geschrieben hat. Mathematiker, die begonnen haben, die Dateien durchzuarbeiten, beschreiben eine gemischte Landschaft: Argumente, die plausibel erscheinen bis zu einem bestimmten Schritt, Definitionen, die auf halbem Weg stillschweigend ihre Bedeutung ändern, und gelegentliche Ergebnisse, die wirklich neu erscheinen.
Chinesische Wissenschaftsautoren waren deutlicher. Ein viel geteilter Essay verglich die Veröffentlichung mit der Entdeckung eines Berges von Müll, wobei Forscher sich die Nase zuhalten und darin nach Gold suchen. Das Bild ist unfreundlich, aber es fängt die tatsächliche Arbeit ein. Jemand muss Zeile für Zeile entscheiden, welche dieser 372 beanspruchten Ergebnisse den Kontakt mit einem menschlichen Experten überstehen.
Dies ist ein bekanntes Muster im maschinellen Lernen. Systeme, die Kandidatenlösungen generieren, überholen die verfügbaren Menschen, die sie verifizieren können, bei weitem – sei es in der Mathematik, der Arzneimittelentwicklung oder der Materialwissenschaft. Die Verifikation wird zum Engpass, und der Engpass bestimmt den tatsächlichen Wert des Werkzeugs. Ein Modell, das zehntausend Hypothesen vorschlägt, ist nur so nützlich wie das Labor, das sie testen kann.
Es gibt auch eine tiefere Frage danach, was das Modell tut. Mathematiker unterscheiden zwischen dem Finden eines Beweises und dem Verstehen, warum ein Satz wahr ist. Eine Maschine kann nach einer Kette gültiger Schritte suchen, ohne die Struktur zu erfassen, die das Ergebnis unvermeidlich macht, und es ist diese Struktur, die es Menschen ermöglicht, ein Ergebnis auf neue Fälle auszudehnen. Wenn die OpenAI-Manuskripte gültige Beweise, aber keine Einsicht enthalten, mögen sie dennoch nützlich sein – aber sie werden allein nicht ändern, wie das Fach denkt.
Vorerst ist die ehrliche Antwort, dass es niemand weiß. Die Manuskripte sind öffentlich, die Behauptungen sind spezifisch genug, um überprüft zu werden, und die Überprüfung hat begonnen. So wurden in der Mathematik schon immer Streitigkeiten beigelegt, und es ist ein langsamerer Prozess als eine Produktankündigung.
Was die Episode jedoch zeigt, ist, dass KI-Unternehmen entschieden haben, dass die Mathematik die Arena ist, in der sie ihre glaubwürdigsten Behauptungen aufstellen können. Das Fach bietet etwas Seltenes in der KI-Debatte: ein Urteil, das nicht von der Meinung irgendjemandes abhängt. Wenn auch nur ein Bruchteil dieser 372 Ergebnisse Bestand hat, wird die Veröffentlichung als Meilenstein in Erinnerung bleiben. Wenn die meisten unter Prüfung zusammenbrechen, wird sie als Lektion über die Kluft zwischen dem Generieren von Text und dem Produzieren von Wissen in Erinnerung bleiben.